AI TOOL · 技术观察 | 2026-10-07 Copilot 让 multi-agent 编排进代码:5 种官方场景 · 4 道可配限额 · 3 种编排模式并列。/fleet 每次让模型决定怎么拆,Dynamic Workflows 每一步都跑一样的路径。 开发者拿回控制权——但计费不透明、preview 不稳、老账单 Pro+ 用不了。 来源:GitHub Changelog(2026-10-01)、GitHub Docs、The Machine Herald(2026-10-06)
先给你演示一个翻车现场。
场景:你写了一条 CI 检查,让 Copilot 用 /fleet 扫一遍仓库里没写测试的文件。
跑第 1 次:Copilot 分了 3 个 agent 并行扫,跑了 6 分钟,报出 47 个。 跑第 2 次:分了 5 个 agent,跑了 11 分钟,报了 39 个。第 5 个 agent 拆出来的是"扫描 node_modules"——纯浪费。 跑第 3 次:Copilot 决定跳过测试目录,跑了 3 分钟,报了 12 个。
同一份代码、同一句 prompt、同一份模型配置——三次结果各不一样。多 8 个、少 14 秒、路径完全跑偏。
这不是 bug。这是 /fleet 的设计:让模型每次自己决定怎么拆。它没有"上次怎么跑的"这个概念。
10 月 1 日 GitHub Changelog,Copilot 上线了 Dynamic Workflows——它做成了你能写代码的东西。
PART 01 · BACKGROUND · 三档编排模式,谁决定任务怎么拆
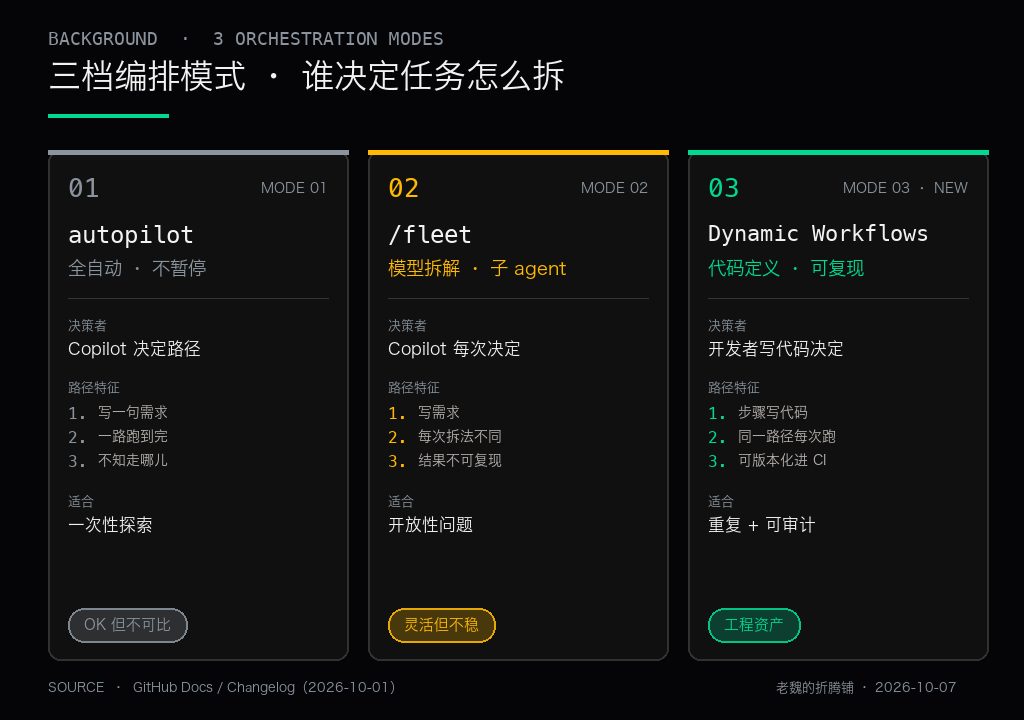
Copilot 现在跑复杂任务有三种模式。前两种你可能一直在用,第三种是这次新加的:
autopilot——Copilot 全程不暂停。你写一句需求,它自己一路跑到完。适合一次性的、路径不确定的探索任务。问题:不知道中间走哪儿。
/fleet——你写需求,Copilot 决定怎么拆成几个子 agent、怎么协调。每次都不一样。适合开放性问题。问题:没有可复现性——这就是刚才演示的那三次不一样的结果。
Dynamic Workflows——你把步骤写在代码里。第 1 步做什么、第 2 步做什么、哪一步并行、哪一步等人审批,都是你决定。Copilot 只在需要"分析或判断"的地方插进来。
GitHub 原话:"The same steps run every time."
这是本周 AI coding 工具集体向开发者拿回控制权的信号——不是给模型更多自主权,是让开发者在代码层面定义流程,模型只做它该做的事。10 月 5 日同周,Anthropic Claude Code 2.1.290 上了 Managed Agents、GitHub Copilot 上了 Computer Use——三条赛道都在做同一件事:把控制权从"模型决定"挪到"人写代码决定"。
PART 02 · CORE FEATURES · 拆开看:workflow 由什么构成
GitHub 给的定义很短:a program that defines how a task is carried out——描述任务怎么跑的一段程序。
这段程序住在哪?Copilot Extension 里——跟 VS Code 扩展、Copilot CLI 插件是同一个扩展系统。可以版本化、可以 review、可以进 CI/CD。
一段 workflow 由两种东西混着构成:
- 自动步骤:跑命令、调工具、传参数
- Agent 步骤:调用一个或多个 agent,让它做需要"分析或判断"的部分
两种步骤之间可以串行(一步一步走),可以并行(几个 agent 同时跑),也可以混合(前一半并行,最后合并)。
GitHub 官方列了 4 个 workflow 具备的能力:
- 结构化结果传递——step 1 的输出结构化喂给 step 2,不是字符串拼接
- 子 agent 互相校验——两个 agent 独立看同一件事,都同意才算通过
- checkpoint 暂停等人——到某一步停下来,人看完再点继续
- 人机交互输入——需要人补充信息时暂停
再加一个 GitHub 官方强调的隐藏能力:你能让它自己写 workflow。你说"帮我给每周的发布检查写个 workflow",Copilot 自己写代码——但你可以 review 再合并。
这里有个陷阱:如果你让它写,然后不 review 就合并,你只是把 /fleet 的"模型决定拆解"换成了"模型决定写代码"。编排权转移的关键是 review,不是代码本身。
PART 03 · CASES · 五个官方场景,共同点是"重复 + 可审计"
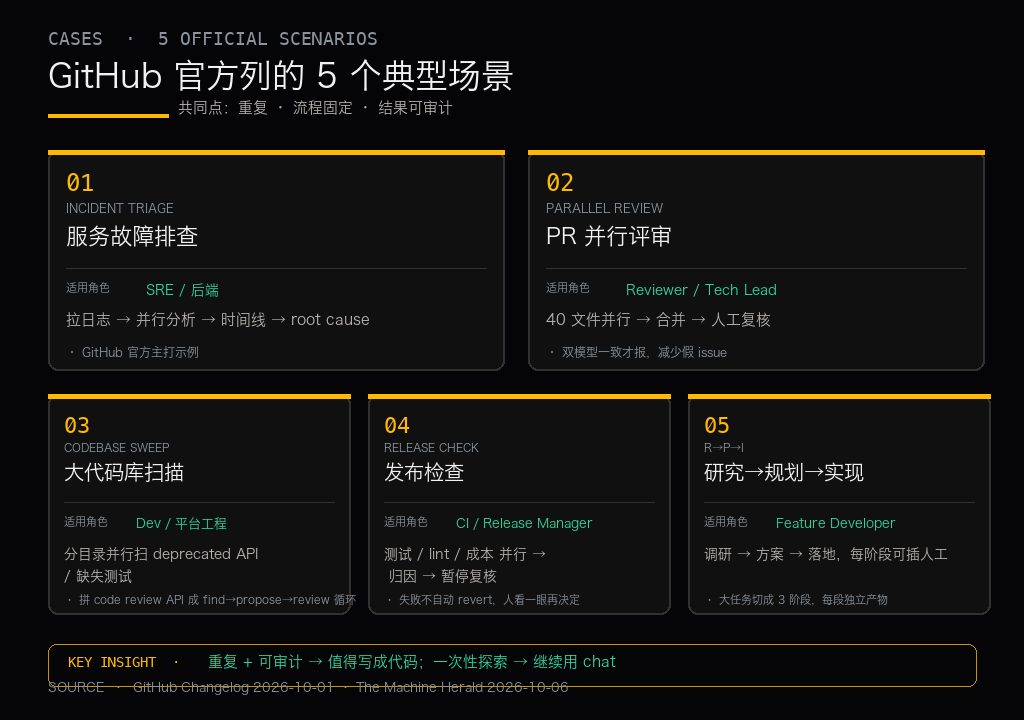
GitHub 官方列了 5 种典型场景。我按生产价值排:
CASE 01|服务故障排查(GitHub 官方主打示例)
需求:生产事故需要快速定位根因,且每次排查流程要可复现、可归档。
方案: 1. Step 1(自动):拉取日志、遥测数据到本地 2. Step 2(并行):3-5 个 agent 各分析一个子系统——数据库 / 网络 / 应用层 3. Step 3(自动):合并结构化输出成时间线 4. Step 4(自动):生成 root-cause 报告 5. Step 5(checkpoint):暂停等人复核后归档
输出:同一份事故数据,每次都跑一样的路径,报告可直接进事后 review。
关键点:以前 /fleet 每次拆法都不一样,排查路径不可比。工作流把"路径"锁死,只有 agent 的判断会变——这才是"根因分析"该有的样子。
CASE 02|PR 评审:多个文件并行审 + 人工复核
需求:大 PR 有 40 个改动文件,逐个读太慢,全丢给一个 agent 又会漏。
方案: 1. Step 1(自动):拉 diff 2. Step 2(并行):每个文件交给一个 agent 独立审 3. Step 3(自动):合并所有 review 意见 4. Step 4(checkpoint):暂停给 reviewer 看合并结果
输出:一次审完全 PR,每份意见可追溯到具体 agent 与具体文件。
变奏:GitHub 官方还给了一个模式——用两个模型分别审同一个 PR,只有两者都同意才报出来。这是"减少模型幻觉导致假 issue"的实用模式。
CASE 03|大代码库扫描:找缺失测试、废弃 API
需求:整个仓库扫一遍找 deprecated API 用法或没测试的文件。
方案: 1. Step 1(并行):分目录交给多个 agent 扫 2. Step 2(自动):汇总结果 3. Step 3(自动):跟 PR 合并触发,配合新 code review API
输出:每周 CI 定时跑,出问题先查报告。
关键点:GitHub 原文:"把扫 API 的 workflow 跟 code review API 拼起来,就变成 find → propose → review 的自动化循环。"这是把 workflow 塞进现有 CI/CD 的具体路径。
CASE 04|发布检查 + 人工复核
需求:发布前跑一系列检查,失败时不自动 revert,得人看一眼。
方案: 1. Step 1-N(并行):跑测试、lint、性能检查、成本预算检查 2. Step N+1(agent):给每类失败做一次归因分析 3. Step N+2(checkpoint):暂停等人决定
输出:每次发布前有审计线索,人工判断有 context。
CASE 05|研究 → 规划 → 实现
需求:一个较大需求要先研究再写方案再落地。
方案: 1. Step 1(agent):调研上下文(读文档、搜代码) 2. Step 2(agent):写方案 3. Step 3(agent):实现 4. Step 4(checkpoint):每阶段可以人工插一次
输出:一个大任务被切成三阶段,每阶段有独立产物可 review。
这五个场景有个共同点:都是重复的、流程固定的、结果需要审计的。GitHub 自己说:"一次性问一句话就用 chat,别用 workflow。"
PART 04 · GOVERNANCE · 四道闸门:这次上线真正的治理基座
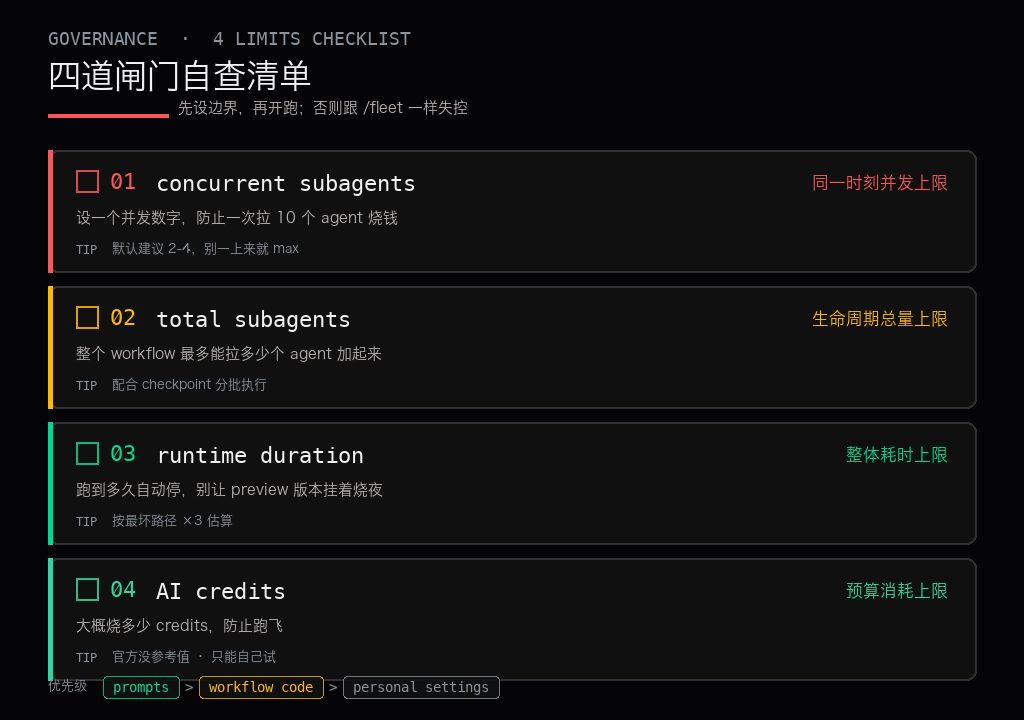
Dynamic Workflows 上线同时给了 4 个可配置的限额——这是它跟 /fleet 最本质的区别:你不仅能定义流程,还能定义它的边界。
| 限额 | 说明 |
|---|---|
| concurrent subagents | 同一时刻能有多少个子 agent 并行 |
| total subagents | 整个 workflow 生命周期能拉起多少个子 agent |
| runtime duration | 整个 workflow 最多跑多久 |
| approximate AI credits | 大概烧多少 AI credits |
这四个限额从 3 个层面都能设:
- prompts(最高优先级)——你在具体运行 workflow 时用 prompt 限
- workflow code——写在 workflow 定义里作为默认值
- personal settings——用户级默认(最低优先级)
优先级顺序:prompts > workflow code > personal settings。跟 K8s 里 resource limits 的分层很像——不同粒度覆盖。
再加上 /workflows 命令:看当前和历史运行、看 AI credits 消耗、暂停/恢复/取消。
这就是"可靠性 + 可观测性"这两个词的具体样子——以前 /fleet 跑飞了没个说法,现在你有个 dashboard 看着它烧多少钱、跑到哪一步。
PART 05 · LIMITS · 三个坑,别一上来就踩
Dynamic Workflows 是好东西,但别当它是万能钥匙。三个坑先摆到桌面上:
坑 1:计费不透明。GitHub 说"可用在所有 Copilot 套餐",但没有单次运行的 credits 参考值。你可以设一个 credits 上限防止跑飞,但设多少才够、又不会卡死流程,官方没给参考。这个只能自己试——但试的成本谁承担?
坑 2:Public Preview 稳定性未定。GitHub 原话:"in public preview and subject to change"。CLI 得开 --experimental 才能用,SDK surface 和 checkpoint UI 都可能变。生产环境用之前先跑一周,看有没有 silent drop——参考 10 月 5 日那篇 Claude Code 2.1.290 上线当天,cloud sessions 就把用户回复权限弹窗的答复吞了,10 月 6 日才在 2.1.291 里修好。preview 期的坑不是一次性的。
坑 3:Plan 说法不一致。Changelog 说"all Copilot plans",但 GitHub Docs 说 Copilot Pro 和 Pro+ 的 legacy annual billing 用不了。你如果是老客户年付 Pro+,得看看自己的账单页——这是官方文档里的不一致,不是翻译错误。
还有一个隐藏坑:Copilot 能写 workflow,但你不 review 就合并,等于把黑盒换了个壳。编排权转移的必要条件是 review,代码本身不是。
SUMMARY · 一句话结论
一句话推荐:Dynamic Workflows 不是"又一个 multi-agent 模式",是 GitHub 把 Copilot 从"你问它答"推到了"你写它跑"。如果你的 multi-agent 流程每周要跑一次以上、且结果要能追溯,就用它;否则继续用 chat。
适合场景:
- 每周/每天重复跑的自动化(发布检查、代码扫描、数据管道)
- 结果需要归档或审计的流程(事故排查、PR 评审)
- 大任务需要拆阶段(research → plan → implement)
- 你想把 multi-agent 流程版本化进 CI/CD
不适合场景:
- 一次性探索、不确定路径
- 需要模型的即兴发挥
- 单次运行、结果不进任何系统
参考资源:
- GitHub Changelog:Dynamic Workflows in Copilot CLI and the Copilot App(2026-10-01)
- GitHub Docs:Concepts / Agents / Dynamic Workflows
- The Machine Herald 深度分析(2026-10-06)
- CLI 打开实验特性:
copilot --experimental或会话内/experimental on - 启用后更新:
/update
本周 AI coding 工具的三条产品线在讲同一件事——把控制权从模型挪回开发者。下周三讲 Computer Use:让 Copilot 帮你点鼠标、敲键盘。到那时你会发现,"agent 是不是失控"这个问题,答案可能一直是同一个:流程由谁决定,不由 agent 决定。