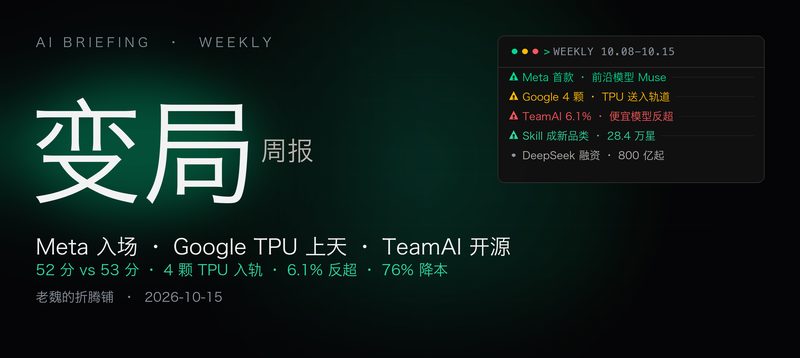
Meta入场、TeamAI开源:这周规矩变了
老魏|AI 资讯周报 | 10/08-10/15 | Meta 首款前沿模型 | Google TPU 上天 | TeamAI 开源
这周有两条消息,我看完第一反应都不是"哇"。
第一条:Meta 憋了三年,终于发了首款对标前沿的模型 Muse Wonder,Artificial Analysis 拿 52 分。第二条:腾讯开源了 TeamAI,把团队的 Skill 塞进 Git 仓库管,官方数据说接了团队知识的便宜模型,评分反比没接的高价模型高 6.1%。
第一条是抢头条。第二条是告诉你别再抢了。
这周真正的分水岭在这儿:模型本身在贬值,团队的知识在升值。
PART 01 · META FINALLY MOVES · 憋了三年,第一枪
Meta 超级智能实验室 10 月 12 号发布 Muse Wonder 和 Muse Wonder Full,这是他们第一次明确对标"前沿模型"。不是拿 Llama 缝缝补补,是正面撞上来。
定价 $4/$20 每百万 token(输入/输出),比自家上一代 Muse Spark 1.3 贵 3.2 倍。但有个反常识的地方——每指数任务成本 4.52 美元,比 GPT-6 Astra 的 3.26 美元贵,智能分却低 1 分(52 vs 53)。贵了,还 slightly 打不过。
有意思的是他们主打什么?"主动记忆"和"主动专注"。
翻译成人话:让模型自己记住上下文,不用你每次重新喂;让它能把长任务拆开一跑几小时,不用你守着。这两个词现在闭源和开源都在抢,因为它是智能体能不能真干活儿的分水岭——跑 10 分钟和跑 10 小时的难度完全不是一个量级。
扎克伯格原话:模型开发"从现在起可能会明显提速"。
⚠️ 顺手纠个错:国内几家媒体写 10 月 13 号发布,官方口径是 10 月 12 号。这种细节别跟着抄。
PART 02 · GOOGLE PUTS TPUS IN SPACE · 4 颗芯片,上了天
Project Suncatcher,谷歌的第一颗测试卫星,最近带着 4 颗 TPU 入轨了。
干啥的?测试太空里的辐射和温度极端环境,能不能扛住 AI 算力。谷歌说这个研究做了好几年,这次是真把芯片送上去开始收真实数据。
这不是"AI 上太空"那种营销词。逻辑很实在:数据中心最贵的是电费和地价,把一部分算力搬到轨道上是条长期路子。当然短期没人这么干——发射成本、散热、辐射防护都是硬坎。这次只是先验证一件事:芯片上去会不会当场坏掉。
跟你日常用 AI 没关系,但值得记住这个信号:算力这事儿,行业开始认真考虑"不放地上"了。
PART 03 · TEAMAI · 把团队的 Skill 当代码管
如果你带过 AI 工具的团队,这条比前面两条都实用。
腾讯云 10 月 10 号开源了 TeamAI(GitHub:Tencent/teamai-cli)。它解决的问题特别具体——
团队用 AI 最先崩的地方,不是模型不够强,是配置散在每个人手里。 同一个规范,有人更新了有人还在用旧版;好用的 Skill 只躺在某个同事的电脑上。人一走,经验就归零。
TeamAI 的做法很朴素:把这些资产当代码管。
- Skill、工作规范、工具配置、项目知识,统一放进一个 Git 仓库
- 成员提 PR,走团队评审
- 合入后,支持 Hook 的 Agent 下次开会话自动拉更新,不用挨个通知
- 管理员能统一下发模型配置,指定涉敏任务走合规的服务
已经适配 16 种 Agent:WorkBuddy、CodeBuddy、Claude Code、Codex、Cursor 等。
最狠的设计是失败经验处理:你在会话里反复纠正 Agent、或者工具调用连着失败几次,会话结束时它会提示你把这段经历分享出来,Agent 整理成文档存回团队仓库。下次别人干类似活儿,先检索仓库里的经验再动手。
官方给的数字:13 个研发任务里,接了团队知识的低成本模型,综合评分比没接的高规格模型高 6.1%,成本低 76%。
我得说清楚:13 个任务的样本量,这个数据不能当普遍结论用。 但它指的方向很具体——当团队知识被结构化沉淀并稳定分发时,补知识的收益可能比单纯换更贵的模型更划算。
这条跟你有直接关系。你在腾讯做企业微信采购,手上的 Skill 库、工作规范、和文档协作的坑,本质就是这类"团队知识"。TeamAI 这套"Git 化 + Hook 自动同步"的思路,比你之前那种散落在各人电脑里的做法结实。
PART 04 · 国内:钱在猛砸,模型在憋 · 十一假期业界静悄悄
有个反常识的事:这周国产模型几乎没发新的。上一次让人眼前一亮的还是阶跃 9/20 的 Step 5 和小米 9/22 的 MiMo-V2.6。
但钱没停:
- DeepSeek:新融资 至少 800 亿元(传闻近 1000 亿),腾讯、宁德时代领投,估值约 5000 亿。另外它的 Harness 智能体执行框架 MIT 协议开源,24 小时 7 万颗星——这数字有点离谱
- 月之暗面:完成上市前最后一轮私募,估值约 500 亿美元,拟 2027 Q1 赴港。Kimi K3 排 GPQA 全球第 9(93.5%),中国模型最高
- 智谱:完成约 50 亿美元融资,年末 ARR 目标从 24 亿上调到 30 亿;GLM-5.3 上线 AWS Bedrock
- 阿里:完成约 800 亿港元配股,全砸 AI 基础设施。Qwen3.8 Max 排 GPQA 全球第 13
- 腾讯:和甲骨文签了 70 亿美元 / 五年 / 约 10 万颗芯片的海外算力租赁
海外那边也不全是好消息,几个硬数字:
- Anthropic 把 Haiku 5.5 的成本砍到比上代低约 75%;但 10/9 更新了使用政策,明令禁止用 Claude 开发或增强武器——这条我觉得比降价重要得多
- Mistral Large 4:万亿总参 / 490 亿激活,原生多模态,语料覆盖 160+ 语言,权重月底开放
- 阶跃 Step 5 今天(10/15)开源 600B 完整权重
一句话:海外闭源拼前沿,国内拼开源和成本。Meta 进场之后,闭源那三家的定价压力会明显加大。
PART 05 · SKILL 生态在长 · GitHub 上的星星和钱往同一条路上走
有个现象挺值得琢磨。
这周 GitHub 上爆的几个 AI 相关项目,四个是 skill 或 MCP 工具,不是模型:
mattpocock/skills28.4 万星,前 TypeScript 教学者 Matt Pocock 的日常 agent skills,已进 Claude Code 官方插件市场,也能装进 Codex / Copilot / Gemini CLIcontext-mode2.6 万星,专门防工具输出撑爆上下文窗口的 MCP servercathrynlavery/diagram-design4.8 万星,44 种图表类型- 腾讯
TeamAI开源
同时 AWS 那边(10/13)把 AI/ML skill 升成 Agent Toolkit 的核心组件,配 Agent 能用一句自然语言走完 SageMaker 全流程:选型 → 训练 → 调优 → 部署。华为鸿蒙 PC 的 DevEco CLI 也把 70 余项 Skills 封装成了命令行接口,一行 init 批量装到本机多个 Agent。
把这些串起来看,信号很清楚:Skills 已经从一个功能,变成了一个品类。
上周我在 GitHub 日报里看到一句话说得挺准——"Agent Skills 已经不再是某个框架的特性,它长成了一个有自己生态的品类"。
而这周的 TeamAI 给这个品类加了一层新东西:版本管理。之前 Skill 是个人资产(写好就放那儿),现在它开始变成团队资产(要评审、要合并、要版本化)。这跟当年 npm 包从个人脚本走向工程化依赖,是一个路子。
PART 06 · SUMMARY · 三句话总结这周
一、闭源这边,Meta 来了但没带来降维打击。 52 分对 53 分、贵 38%、主打主动记忆——这是稳扎稳打入场,不是掀桌子。真正被压价的是 Anthropic 和 OpenAI 的中间档位(Haiku 5.5 砍 75% 成本就是反应)。
二、Google 上天那件事,别当新闻看,当信号看。 算力往天上放不现实,但它证明大厂在认真算电力和地价的账。长期变量。
三、如果你只带走一件事:别再纠结用哪个模型,把团队的 Skill 沉淀下来。 TeamAI 那组 13 个任务的数据虽然样本小,但它和 AWS 把 skill 做进核心工具链、华为做 70 项 Skill 接口、GitHub 28 万星 skill 库,指向的是同一个方向。模型是租的,知识是自己的。
下周蹲守:10/22 阿里 Qwen4(预计)、10/23 小米 MiMo-V3(预计)、本周内 Mistral Large 4 权重开放。
本文为资讯周报,发布前经多源交叉核对;标注"预计/传闻"的均未经官方确认,别当定论用。有错的地方欢迎后台拍砖。