1024 agent 开源:最好 79.59%,均值 28%
老魏|AI 编程工具观察 | Microsoft Research 10-24 摊出 Agensh MIT · 5 题均值 19.31%→28.78%(+9.47 分)· pandoc 最好 79.59%(GPT-6.1-sol 32 agent,非论文 v1)· 16 节点×64 agents×6h 才跑成 1024 局 · token 成本未披露 · MarkTechPost + arXiv 2609.26781 + 5 源交叉验证
上周有哥们问:微软不是刚摊出 1024 个 agent 的编排框架吗?听起来比 Recursive 那个 4 个月 40B 还猛啊。
我说:你先看 5 题均值。28.78%。
他说:……啥意思。
我说:意思是——1024 个 agent 一起上,比 1 个 agent 只多对了 9.47 分。而且这还不是最好成绩,最好成绩是另一张图上的 79.59%,那是单题、另一个模型、非论文 v1 的数字。
PART 01 · THE SETUP · 1024 个 agent 没有老板
10-24 晚上,微软亚研的 Zhihao Zhan 在 X 上挂出 Agensh:github.com/microsoft/Agensh,MIT 授权,1.0 版本,代码 + 实验启动脚本 + 复现指南一套打包。arXiv 论文 2609.26781 早在 9-22 就发出去了,隔了一个月代码才跟上来——微软摊开的是过程,不是姿态。
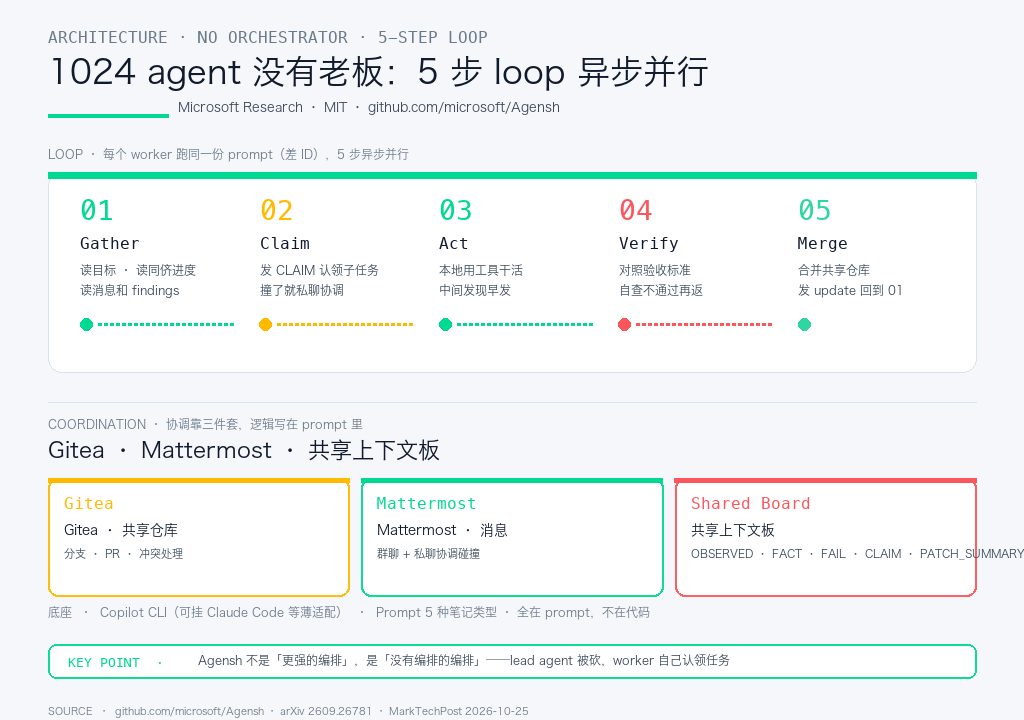
Agensh 的核心理念就一句:砍掉中央编排器(orchestrator)。传统的 Claude Code agent teams、Codex sub-agents、Copilot fleet、Kimi Agent Swarm 都是「一个 lead agent 派活、合并、验收」的结构,lead agent 就是天花板。Agensh 直接把 lead 拿掉,每个 worker 跑同一份 prompt(唯一的区别是 ID),5 步 loop 异步并行:
- Gather:读目标、读同侪进度、读消息和 findings
- Claim:发 CLAIM 认领子任务,撞了就私聊协调
- Act:本地用工具干活,中间发现早发
- Verify:对照验收标准自查
- Merge:合并进共享仓库,发一条 update,回到第 1 步
底层是 GitHub Copilot CLI,官方说薄适配器也能挂 Claude Code。协调靠三件套:Gitea(共享仓库 + PR + 冲突)、Mattermost(群聊 + 私聊)、共享上下文板(存 5 种类型的笔记:OBSERVED / FACT / FAIL / CLAIM / PATCH_SUMMARY,改编自 DeLM)。整个协调逻辑写在 prompt 里,不在运行时代码里。
一句话总结:Agensh 不是「更强的 agent 编排」,是「没有编排的 agent 编排」。
PART 02 · THE NUMBERS · 数字摊开
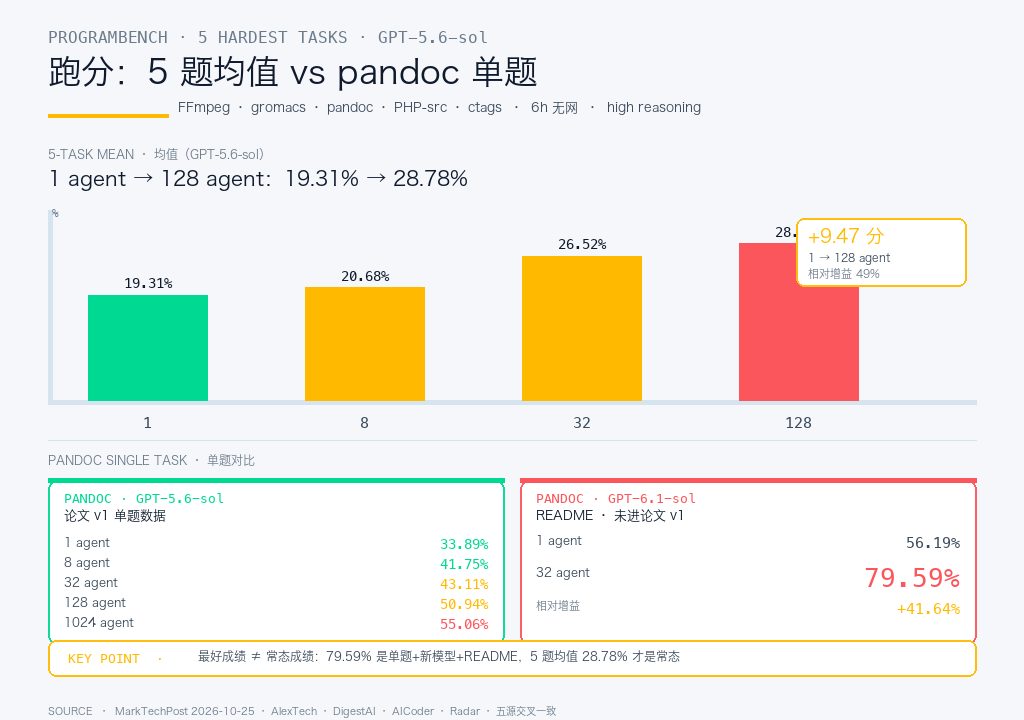
5 个 ProgramBench 最难任务:FFmpeg / gromacs / pandoc / PHP-src / ctags。要求从「观察到的行为 + 附带文档」重建程序,6 小时,全程无网。GPT-5.6-sol high reasoning。
5 题均值(GPT-5.6-sol):
1 agent 19.31% → 8 agent 20.68%(+1.37 分)→ 32 agent 26.52% → 128 agent 28.78%。
从 1 到 8 只加了 1.37 分,从 1 到 128 总共加了 9.47 分(相对增益 49%)。听着不算少,但你得看清分母——5 题均值只到 28.78%,剩下 71% 的题还是没做出来。
pandoc 单题(GPT-5.6-sol):
1→33.89% / 8→41.75% / 32→43.11% / 128→50.94% / 1024→55.06%。
128 → 1024 只加了 4.12 分,边际收益递减已经很明显。128 agent 30 分钟就能到 30%,8 agent 要 90 分钟——速度换分数的账是划算的。
pandoc 单题(GPT-6.1-sol,README 数字,非论文 v1):
1→56.19% / 32→79.59%(相对增益 41.64%)。这就是标题里的「最好 79.59%」——注意三个限定词:单题、另一个更新的模型、README 上的数,v1 论文里没有。
硬件方面:默认单机 8 worker,1024 局要 16 节点 × 64 agents × 64 GiB worker 内存。每个 worker 272K input / 128K output。
PART 03 · THE GAPS · 数字没告诉你的
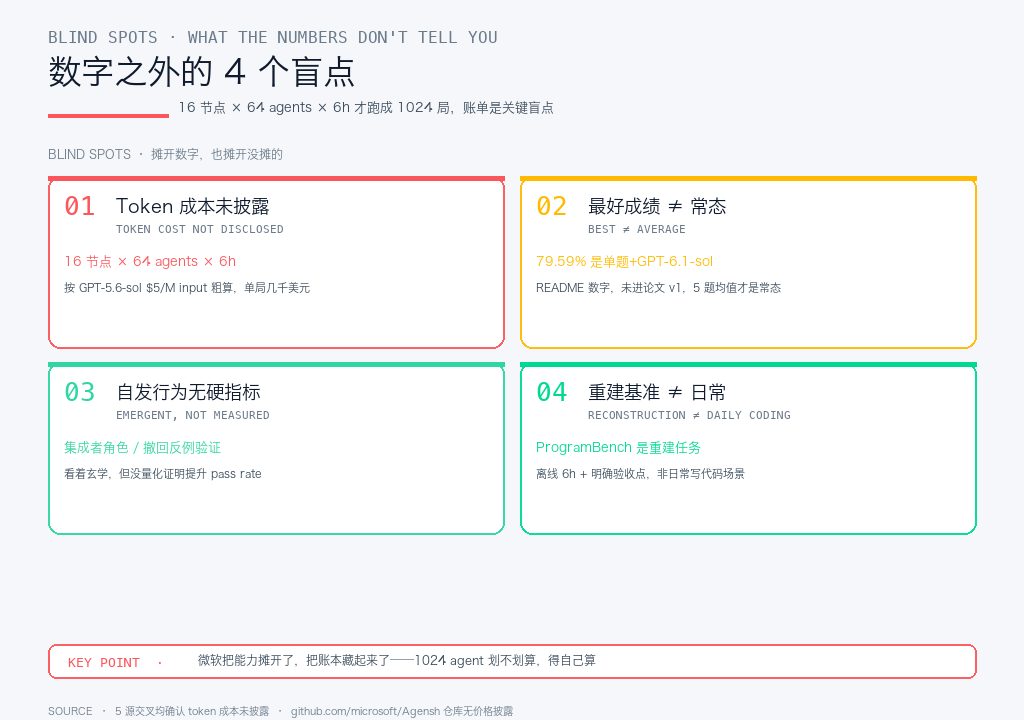
盲点 1:1024 局的 token 账单,谁都不知道。
5 篇独立报道(MarkTechPost / AICoder / DigestAI / AlexTech / Radar)口径一致:token 成本未披露。16 节点 × 64 agents × 6 小时 × GPT-5.6-sol,就算按 $5/M input + $30/M output 单价粗算,单局也在几千美元量级。这不是「多 agent 强不强」的问题,是「多 agent 划不划算」的问题——微软把能力摊开了,把账本藏起来了。
盲点 2:最好成绩 ≠ 常态成绩。
GPT-6.1-sol pandoc 32 agent 79.59% 是全篇最亮的数字,但它出现在 README 里、不在 v1 论文里、也不是均值——是单题 + 单模型 + 单配置下的最好成绩。5 题均值 28.78% 才是常态。用最好成绩判断系统,和用明星员工代表团队,是同一种错觉。
盲点 3:自发行为很唬人,但没有硬指标。
作者观察到 8 agent 会自动商量接口、32 agent 会互相审阅并撤回一次反例验证、128 agent 会复用可信审阅者标准化整合协议、1024 agent 会出现「集成者」角色和「恢复失败任务」的同侪。这些角色都不是写死的——听着挺玄学,但没有量化指标证明这些自组织能力真的提升了 pass rate。
盲点 4:ProgramBench 是重建任务,不是编程任务。
5 题都是「根据行为重建 FFmpeg / gromacs / pandoc / PHP-src / ctags」——离线 6 小时、无网、有明确验收点。这不是日常写代码的场景,是特定类型的对抗性重建基准。日常写业务代码能不能复现这个 28.78%,官方没测。
CASE 01|单节点试水 Agensh
需求:不想上 16 节点,先在自己机器上看看「多 agent 到底加几分」。
方案:
- 环境:Linux + Docker Engine + Compose v2 + systemd + cgroup v2 + Python 3.11+
- 拉代码:clone github.com/microsoft/Agensh,装 ProgramBench v1.2.5
- 跑 baseline:单 agent 模式先跑一次 pandoc,拿到参考分数
- 跑 8-worker:起单节点 8 worker 默认配置,同样 6h 预算,看分数是涨 8 分还是 1 分
输出:一份可复现的 1 vs 8 agent 差值报告,判断「分任务」在你自己的硬件和预算下到底划不划算。
SUMMARY · 一句话结论
「1024 agent 听起来很猛,但 5 题均值只到 28.78%——最好成绩 79.59% 是单题+新模型+README 数字,不是常态。token 成本没披露,才是最大盲点。」
Agensh 的价值不在于「跑得多强」,在于「把过程摊开」——第一次有人把「没有 orchestrator 的多 agent 编排」写成可复现的 MIT 代码。递进 1014「造 agent 没人及格」和 1023「Recursive 4 个月 40B」之后,主线是:AI 造 AI 摊开过程的方式越来越硬,摊开数字的方式却越来越谨慎。
适合:想上多 agent 编排但不想盲信营销的程序员;团队正在评估 Copilot/Claude Code agent teams 用不用扩规模的架构师;关注「AI 造 AI」这条赛道但不想只读宣传稿的观察者。
参考:github.com/microsoft/Agensh · arXiv 2609.26781《Agensh: Scaling Organizational Intelligence to 1,024 Agents》· MarkTechPost 2026-10-25《Microsoft Open-Sources Agensh: A Multi-Agent Harness for 1,024 Agents》· AICoder 2026-09-24 · AlexTech · DigestAI · Radar · 项目页 agens-harness.github.io/project/