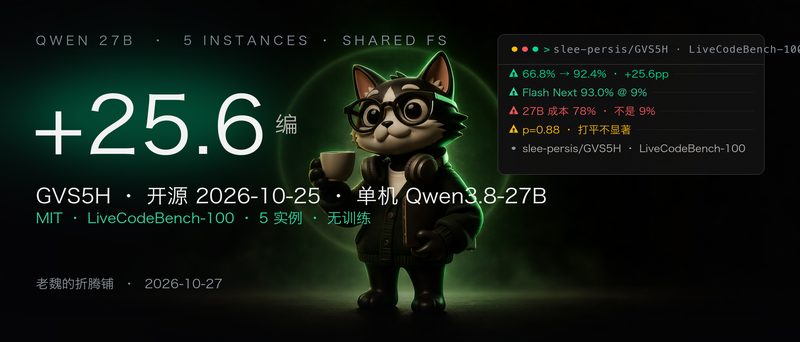
AI TOOL · 实战拆解 · 2026-10-27 昨天 1024 agent 均值 28.78%,今天 5 个 Qwen 92.4%。差不是数量,是编排。 +25.6pp · 无训练 · 78% 成本(不是 9%) · 统计打平(不是赢)
5 个 Qwen 27B,编排出 25.6 分
翻车现场
刷到 GVS5H 那天晚上,我盯着 GitHub 看了 20 分钟。三个「你以为」的开场:
「开源 5 个 Qwen 27B,成本只要 Fable 5 的 9%」——错的。9% 是 Qwen3.8-Flash Next 的数据,27B 实际成本 $47.82/pass,是 Fable 5 $61.11/pass 的 78%(据公开报道)。
「5 个 Qwen 编排出 92.4%,超过了 Fable 5 的 90.4%」——打平。2 分的差距 Holm 校正后 p=0.88,统计不显著(据公开报道)。
「本地单机 Qwen 27B 能跑」——要 100 小时跑 100 题。用 RX 7900 XTX 一张卡,7.42M output tokens(据公开报道)。
昨天刚讲完微软 Agensh——1024 agent 5 步 loop 均值只到 28.78%。今天这个开源项目反着来:把 agent 数压到 5,把编排密度拉满,用同一份 27B 模型跑出接近旗舰的成绩。差在数量吗?不在。差在怎么把这 5 个「同一个脑」管起来。
PART 01 · RECAP · 昨天和今天,数字对撞
先把这两天的账并排放:
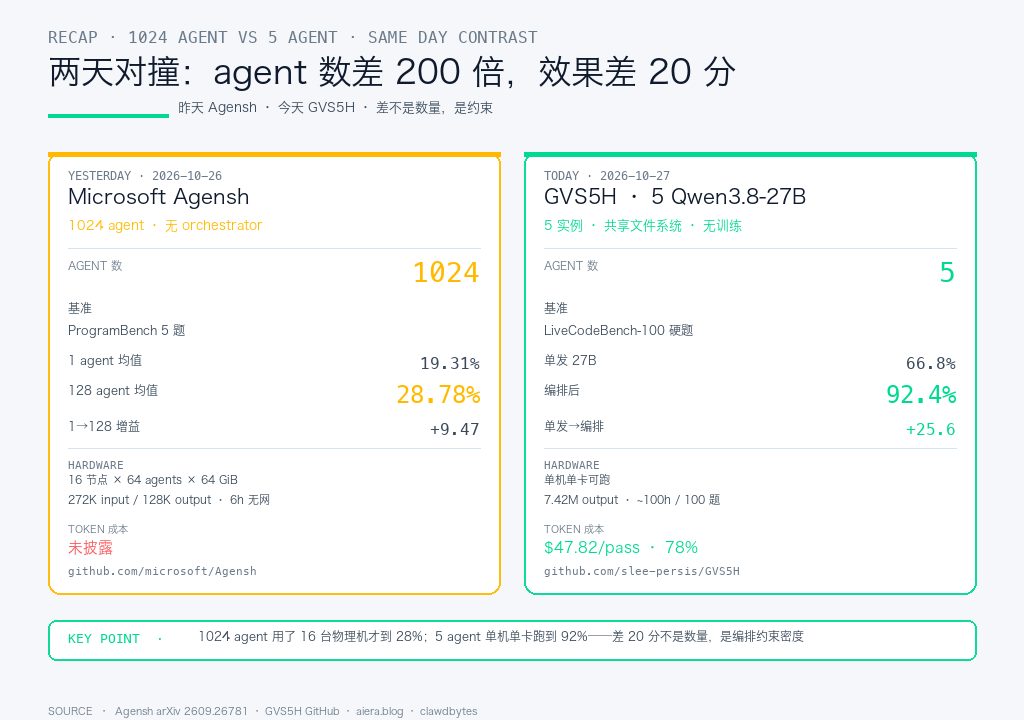
- 昨天:1024 个 agent 跑同一份 prompt,共享 Gitea + Mattermost + 上下文板,5 步异步 loop(Gather→Claim→Act→Verify→Merge)——ProgramBench 5 题均值从 1 agent 的 19.31% 涨到 128 agent 的 28.78%(+9.47 分,相对增益 49%)。硬件 16 节点 × 64 agents × 64 GiB worker,272K input / 128K output,6 小时无网。
- 今天:5 个 Qwen3.8-27B 实例通过共享文件系统协作,10 轮循环封顶——LiveCodeBench-100 硬题从单发 66.8% 拉到 92.4%(+25.6 分)。单机单卡可跑,无训练、无微调、无 RL。
两个数字看着像打架:1024 agent 均值 28%,5 agent 拉出 92%。别急着下「多 agent 没意义」的结论。它们测的题、跑的基准、给的能力都不同——ProgramBench 是 5 个最难的开源项目 bug,LiveCodeBench-100 是 100 个最近的最难算法题,一个是工程重构一个是竞赛题。
真正的差异在编排的约束密度——GVS5H 把 agent 装进了一个「有账本、有验证器、有轮数上限」的盒子里,而 Agensh 是让 agent 在 Gitea 里自由协作。同样是「多 agent」,一个被硬约束锁死,一个自由发挥。
再补一行对照:微软 1024 agent 用了 16 台物理机、6 小时、token 成本未披露;GVS5H 5 agent 单机单卡可跑、100 小时、78% 成本。这不是「多 agent 好」或者「单 agent 好」的问题,是你愿意为哪类题目、付哪种代价。
PART 02 · MECHANISM · 五个角色 + 五个文件 + 五处硬约束
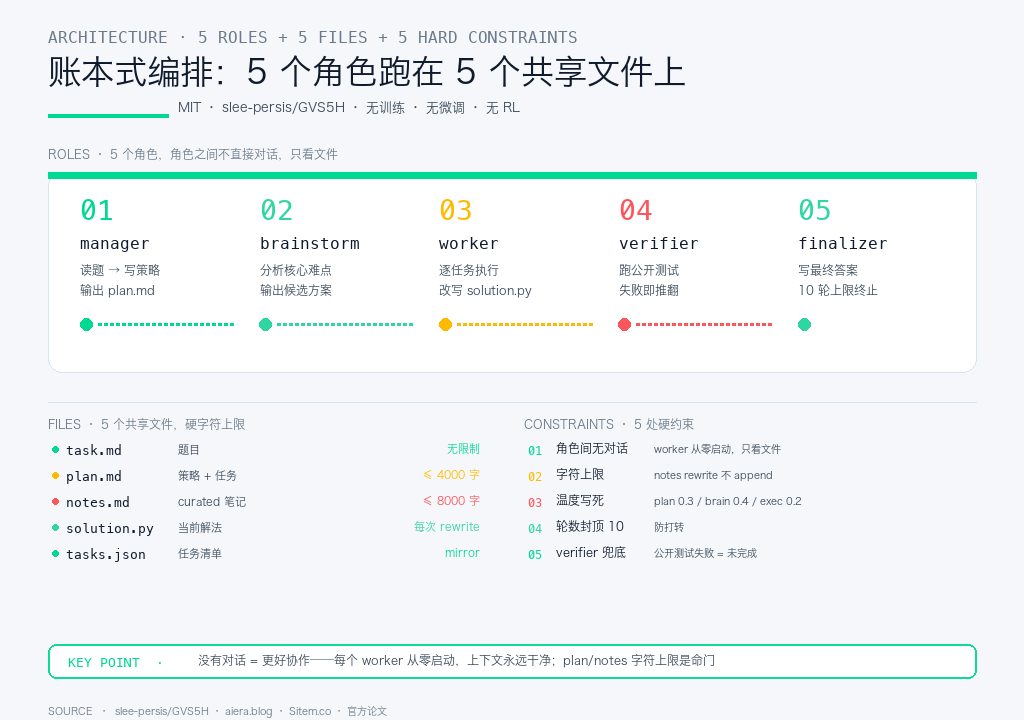
GVS5H 的核心不是「多 agent」,是「账本式编排」。整套系统只有 5 个角色,跑在 5 个共享文件上,被 5 处硬约束钉死。
- 5 角色:manager 读题 → worker 分析难点 → worker 逐任务执行 → verifier 跑公开测试 → finalizer 写最终答案。角色之间不直接对话,只看文件。
- 5 文件:
task.md(题目)、plan.md(manager 写的策略 + 3-6 个种子任务,≤4000 字)、notes.md(curated 笔记,≤8000 字,rewrite 不 append)、solution.py(当前解法)、tasks.json(任务清单)。 - 5 处硬约束: 1. 角色间无对话,只能通过文件交换——每个 worker 从零开始,无历史包袱。 2. plan/notes 硬字符上限——notes 不 rewrite 就会 rot(每个 worker 继承更长的历史,早期错误想法一直往下传)。 3. 温度写死:plan 0.3 / brainstorm 0.4 / execute 0.2——创造性只在 plan 和 brainstorm 环节,执行时压到最低。 4. 轮数封顶 10——防打转。 5. 公开测试失败 = 未完成——verifier 的失败比 manager 的「我觉得做完了」优先。
+25.6 分不是来自 agent 数量,是来自这 5 处约束。同一份 27B,无约束单发 66.8%,套上这套 harness 变 92.4%——模型权重一个字节都没动。
这里有个反直觉的点:没有对话 = 更好协作。传统 agent 编排要么共享消息队列(容易互相打断)、要么共享 chat history(越拉越长、上下文污染);GVS5H 直接让每个 worker 从零启动、只看文件、任务结束就销毁——上下文永远干净,代价是每个 worker 都要重新读一遍 plan 和 notes。
这也是为什么 plan/notes 的字符上限是命门——如果这两个文件失控膨胀,每个 worker 都会读进更多噪声,10 轮之后 loop 就会 rot。项目作者把 plan 卡在 4000 字、notes 卡在 8000 字、并且强制 notes 每次重写而不是追加,就是为了让每次 worker 启动都能拿到当前最有价值的笔记,而不是历史累积的垃圾。
温度也值得单独说:plan 0.3 是最创造性的环节(manager 需要跳出题面找策略),brainstorm 0.4 稍保守一点(worker 出候选但要收敛),execute 0.2 压到最低(跑任务要稳)。这三个数字看起来是拍的,但对照 1024 agent 那种「同一份 prompt 无差异化」的设计,同一模型不同角色温度不同 = 让每个 agent 做它擅长的事。
PART 03 · BILL · 摊开的账本,和没摊开的部分
先摊账本,再谈上限。
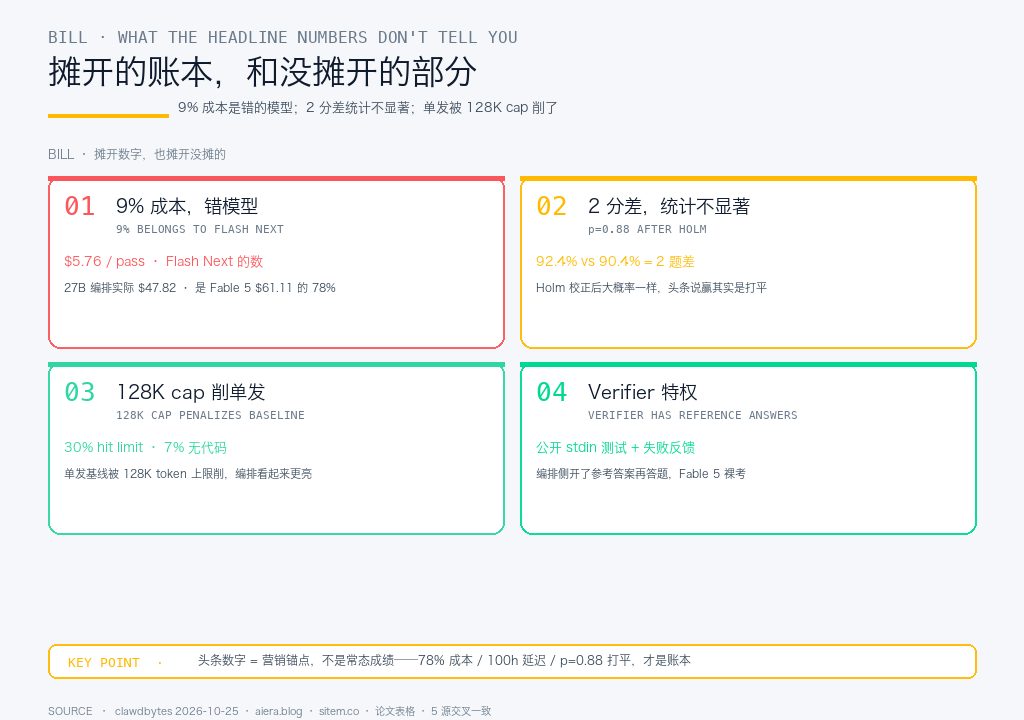
成本:$47.82 vs $61.11,78%——不是 9%。 「9% 成本」这条流传最广的数字,属于 Qwen3.8-Flash-Next(更大更省的模型)。27B 那套 harness 因为要 5 个实例跑 10 轮,output token 从 Fable 5 的 1.20M 飙到 7.42M——6.2 倍。按 API 计费摊下来是 78%,不是 91% 便宜。
延迟:单机单卡 100 小时跑 100 题。 按 ClawdBytes 的估算(据公开报道),27B manager scaffold 一共要吐 18.6M output tokens,跑在 RX 7900 XTX 一张卡上、不做 batch——100 题大概要 100 小时。这意味着你不能用 GVS5H 做交互式补全,它只适合「提交一批题、几小时到几天后拿结果」的离线跑分场景。
对比一下:Fable 5 单发是同步返回、秒级延迟;GVS5H 27B 编排是离线跑批、小时级延迟。这两件事根本不是同一个使用场景——你如果拿 GVS5H 去对标「Copilot 补全速度」,那是苹果比橘子。
统计显著性:p=0.88,2 分不显著。 92.4% 对 90.4% 差 2 分,100 题里 2 题。Holm 校正后 p=0.88——这数字的意思是「两模型大概率一样」。头条说「超过」,学术口径是「打平」。
Token 上限:单发 128K cap,30% 触顶,7% 无代码。 单发 Qwen 27B 的基线被 128K token cap 削了不少——30% 的请求 hit limit,7% 完全没吐出代码。这拉低了单发的基线,也让编排看起来比实际的对比更亮。
Verifier 特权:有公开测试反馈,单发基线没有。 GVS5H 的 verifier 跑公开 stdin 测试、把失败喂回 loop,这是 baseline 没有的能力。相当于让 GVS5H 开了「参考答案」再答题,让 Fable 5 裸考——这不是公平赛跑,这是把测试条件都摊给编排侧。
PART 04 · TRANSFER · 这个模式,你什么时候该抄
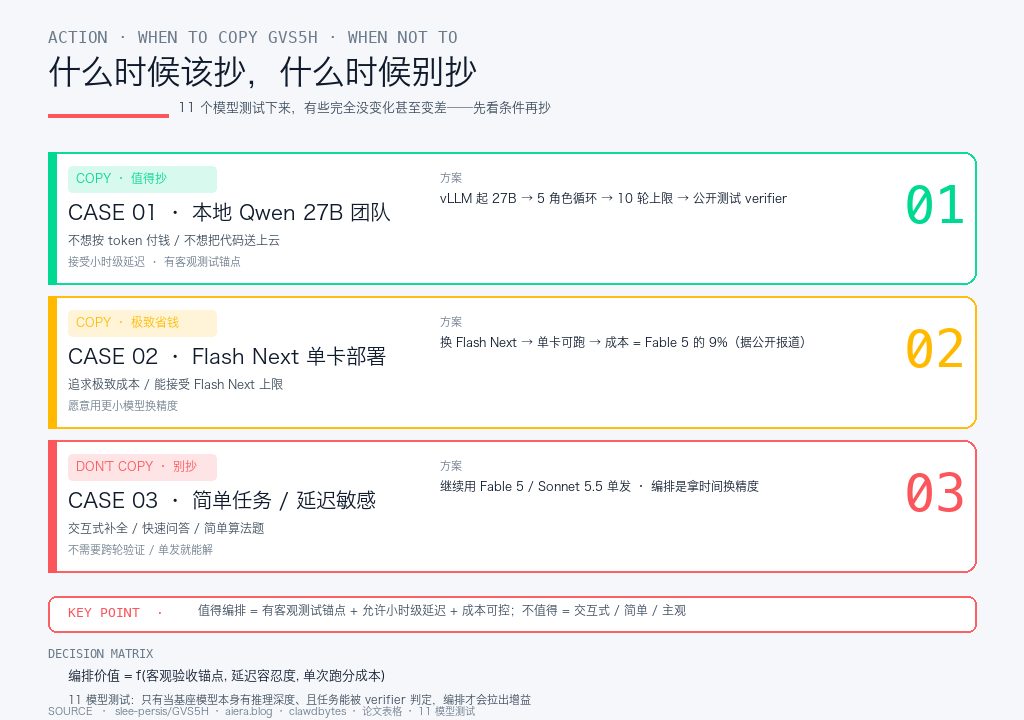
GVS5H 不是万灵药——11 个模型测试下来,有些完全没变化甚至变差。但有几类场景可以照搬它的思路:
CASE 01|本地部署 Qwen 27B 的团队
- 需求:不想按 token 付钱、不想把代码送上云、预算紧但追求可控成本
- 约束:能接受小时级延迟、不追求交互式补全、题目有客观验收方式(有单元测试/有公开 test case)
- 方案:
1. 用 vLLM 起本地 Qwen3.8-27B,配 GVS5H 的
run_bench.py --engine multiagent或自研 harness 2. 用 manager-worker-verifier 三角色循环跑复杂任务,最多 10 轮 3. 必须用公开测试做 verifier——没有客观验收锚点就退回主观判断,这套 harness 的价值就掉一半 4. 10 轮上限、plan ≤4000 字、notes ≤8000 字硬编码,防 loop rot 5. 温度写死:plan 0.3 / brainstorm 0.4 / execute 0.2 - 输出:
solution.py+plan.md+notes.md+ 每任务的 token/cost 报告 + verifier 通过记录 - 不推荐:如果你的题目没有客观测试锚点(比如「帮我优化这段代码的性能」这种主观判断),先跳过,等你的 harness 有客观验收再说
CASE 02|用 Flash Next 上单卡、要极致省钱
- 需求:追求极致成本、能接受稍差的模型能力
- 约束:愿意用更小更省的模型换精度,能接受 Flash Next 在难题上比 27B 差一些
- 方案: 1. 换 Qwen3.8-Flash-Next 跑同样的 harness 2. 单卡可跑,成本 = Fable 5 的 9%(据公开报道,Flash Next 的编排 pass 成本是 $5.76,27B 是 $47.82) 3. 精度 93.0%,比 27B 编排的 92.4% 还高 0.6 分——更小的模型+更好的编排 = 更好的结果
- 输出:单卡可跑的推理配置 + 一份 pass@1 复现脚本
- 风险提示:9% 成本的前提是你能接受 Flash Next 的能力上限——它比 27B 小,在需要推理深度的题上会更容易崩,verifier 会更频繁触发重跑
CASE 03|单发就够的简单任务,别抄
- 需求:简单任务、单次调用、延迟敏感(交互式补全 / 快速问答)
- 约束:不需要跨轮验证、不需要复杂分解、单发就能解
- 方案:继续用 Fable 5 / Sonnet 5.5 / GPT-5.6 Sol 单发,别硬套 GVS5H——编排是拿时间和 token 换精度,简单任务 78% 成本换 2 分收益不划算,何况这 2 分还不显著。
- 输出:继续单发的成本报告 + 一份「什么任务值得走编排、什么任务不值得」的决策清单
决策清单: - 值得编排:任务有客观测试锚点、允许小时级延迟、单次跑分成本能控制在预算内 - 不值得编排:交互式补全、简单算法题(单发就够了)、主观判断题、任务本身 5 分钟能写完
PART 05 · TAKEAWAY · 一句话结论
编排质量 > 模型数量。
昨天 1024 agent 均值 28.78%,今天 5 agent 编排出 92.4%——差 20 分不在数量,在约束密度。GVS5H 用「角色分工 + 文件账本 + 硬字符上限 + 温度写死 + 验证器兜底」这五件套,把 5 个「同一个脑」装进了一个能真正交付的盒子里。
代价也要说清楚:token 账单涨了 78%(不是省了 91%),单次任务可能拉到 100 小时,2 分差统计不显著。这不是万灵药——不是所有模型都能受益,也不是所有预算都扛得起。
但方向是清楚的:当你的核心问题不是「模型不够大」,而是「agent 不够严」——那 GVS5H 给的这套「有账本、有验证器、有轮数上限」的编排思路,值得抄。
一句话推荐:如果你想在本地跑 Qwen 27B 又不想被 token 账单打脸,先读一遍 GVS5H 的 harness 再上手。
适合场景:本地开源模型编排 / 预算紧但要可控成本 / 有公开测试可当验证锚点的复杂任务。
参考资源:GVS5H 项目(据公开报道代码 MIT / 论文 CC BY 4.0)· slee-persis/GVS5H · LiveCodeBench-100 硬题集。