Java RAG 合集⑤:先分档,再选库——向量库选型与 PGVector 实战
上篇结尾我埋了个坑:initialize-schema。今天填上。
但填坑之前,先治一个更常见的病:选库焦虑症。症状是项目还没写一行代码,先花两周调研 Milvus、Qdrant、Weaviate、Chroma,做了个五维对比表格,最后选了 Milvus——因为简历上好看。
病根只有一个:你根本不知道自己的数据量在哪个档位。
读完你应该能:
- 用「数据量 + 运维能力」两个维度给项目分档,十分钟定下选型
- 搞懂 HNSW 索引为什么快,以及三个参数各管什么
- 从 Docker 到带元数据过滤的检索,六步跑通 PGVector
- 避开五个坑(含 2.0 的 initialize-schema 破坏性变更)
一、先分档:你的项目根本轮不到 Milvus
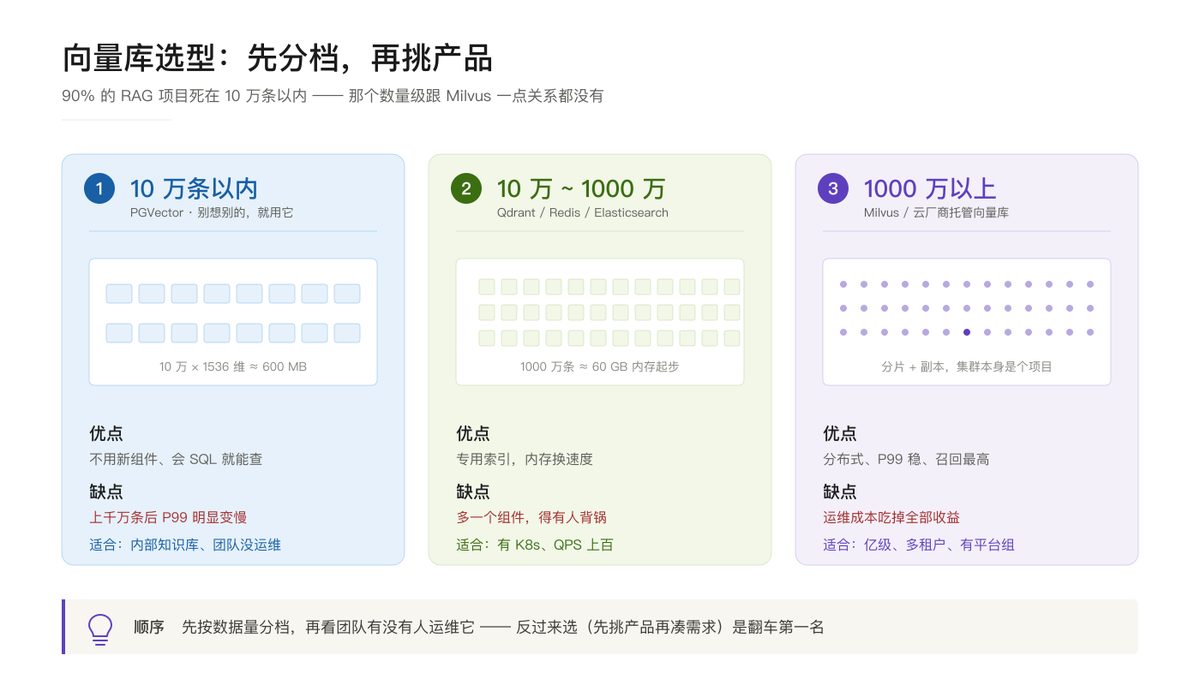
向量库选型没有标准答案,但有非常清晰的分档逻辑。就两个问题:
第一问:向量大概多少条? 第二问:团队里谁背运维的锅?
直接给结论(数量级凭 1000 万条 768 维的公开参考数据:Milvus HNSW 召回率约 0.88-0.92、P99 约 25-45ms;PGVector HNSW 约 0.85-0.90、P99 约 40-80ms——机器配置不同差异很大,看量级别看个位数):
| 你的情况 | 选它 |
|---|---|
| 10 万条以内、没人专职运维 | PGVector(Postgres 插件) |
| 10 万 ~ 1000 万、有 K8s 有人运维 | Qdrant / Redis / Elasticsearch |
| 1000 万以上、多租户 SaaS | Milvus 或云厂商托管向量库 |
算笔账你就踏实了:10 万条 1536 维向量,float32 存储也就 600 MB。这个体量塞给任何专用向量库,都属于「开跑车去买菜」——能开,但停车比开车费劲。
而 PGVector 是个 Postgres 插件:事务、备份、权限、监控,全部白送。你的 DBA 不用学新东西,你的运维不用多管一个组件,你的 Spring Boot 配置文件里连一个新的中间件地址都不用加。
10 万条以内选 Milvus 的,本质是简历驱动开发。 不是不行,是维护成本远超收益——等哪天真到千万级,迁移的成本也比从零维护一个 Milvus 集群低得多。
二、HNSW:为什么它快,以及三个旋钮
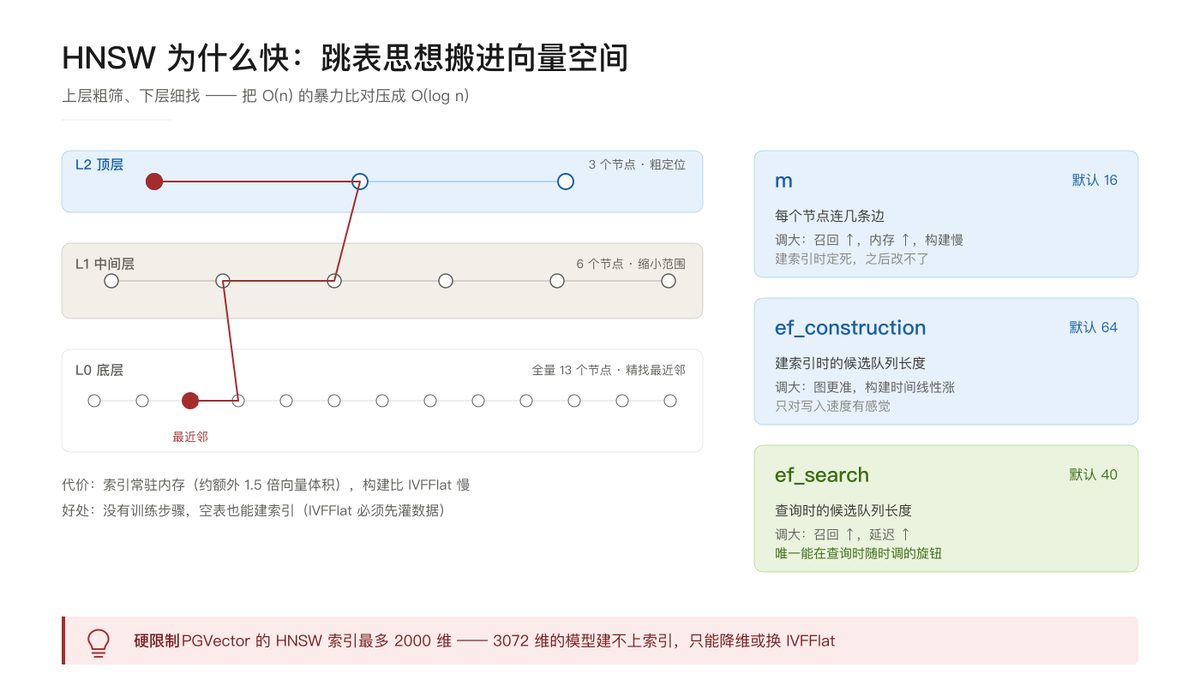
PGVector 默认给你建的是 HNSW 索引(分层可导航小世界图)。名字唬人,思想就是你背过的跳表:
- 想在 100 万个向量里找最近邻,挨个比一遍是 O(n),慢死了
- HNSW 把数据分层:顶层稀疏(远距离「跳跃」),底层全量(精确查找)
- 查询从顶层进入,先粗定位,再逐层下钻,越往下越精细——复杂度压到 O(log n)
三个参数决定它的脾气,Spring AI 的配置里没暴露它们,自动建表时用 pgvector 默认值:
- m(默认 16):每个节点连几条边。调大召回升、内存涨、构建慢。建索引时定死,之后改不了。
- ef_construction(默认 64):建索引时的候选队列长度。影响索引质量,只对写入速度有感觉。
- ef_search(默认 40):查询时的候选队列长度。唯一能在查询时随时调的旋钮——召回不够就调它,
SET hnsw.ef_search = 100;
顺带认识一下落选的 IVFFlat:构建快、省内存,但查询的速度-召回权衡不如 HNSW,而且要先有数据才能训练聚类中心(空表建不了)。所以 Spring AI 默认 HNSW,没毛病。
但有个硬限制必须背下来:PGVector 的 HNSW 索引最多支持 2000 维。 你要是用 text-embedding-3-large(3072 维),索引直接建不上——要么换 1536 维的模型,要么降维,要么换 IVFFlat。这个坑官方文档写在小字里,网上教程基本不提。
三、动手:六步把 PGVector 跑起来
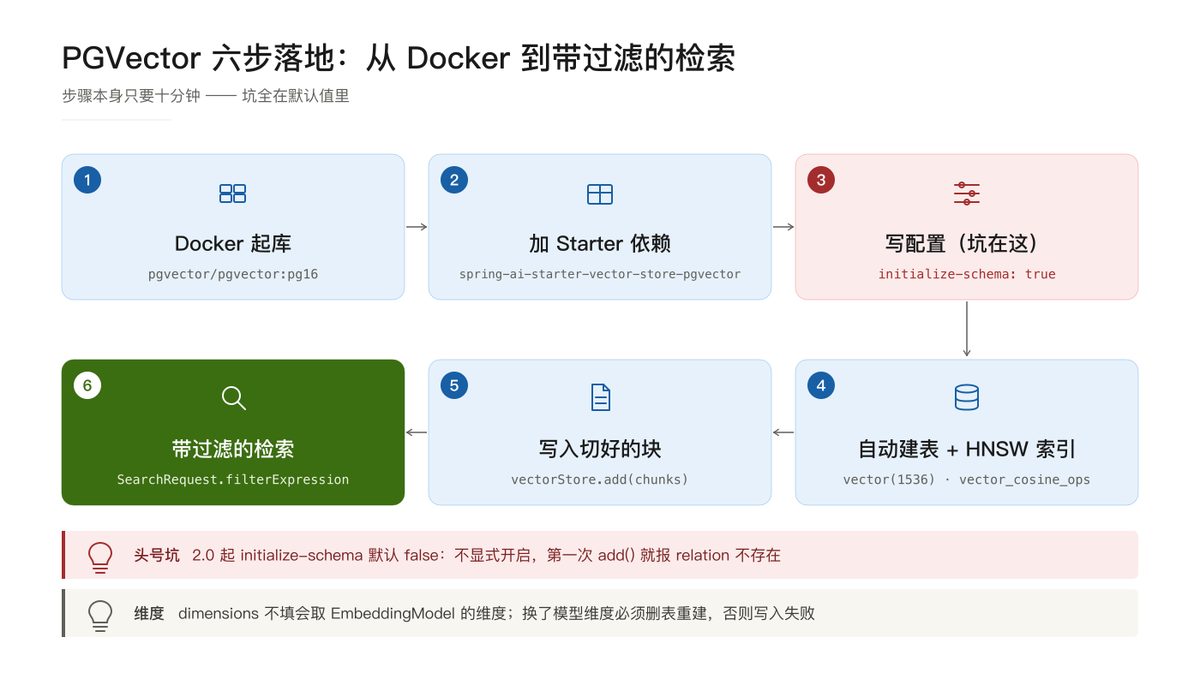
第 1 步:Docker 起库
官方镜像自带 pgvector 扩展,不用自己编译:
docker run -d --name pgvector \
  -e POSTGRES_PASSWORD=postgres \
  -p 5432:5432 \
  pgvector/pgvector:pg16
第 2 步:加依赖
<dependency>
    <groupId>org.springframework.ai</groupId>
    <artifactId>spring-ai-starter-vector-store-pgvector</artifactId>
</dependency>
<!-- EmbeddingModel 别忘了,第③篇配过 openai starter -->
注意 artifact 名:2.0 改成了 spring-ai-starter-vector-store-pgvector,网上老教程里的 spring-ai-pgvector-store-spring-boot-starter 已经是过去式。BOM 管版本,这个第②篇讲过,不重复。
第 3 步:写配置
spring:
  datasource:
    url: jdbc:postgresql://localhost:5432/postgres
    username: postgres
    password: postgres
  ai:
    vectorstore:
      pgvector:
        initialize-schema: true   # 2.0 默认 false!不开就踩坑
        index-type: HNSW          # 默认就是 HNSW,写出来是自文档化
        distance-type: COSINE_DISTANCE
        dimensions: 1536          # 不填也行:自动取 EmbeddingModel 的维度
第 4 步:建表(自动的)
initialize-schema=true 时,启动会自动装三个扩展(vector / hstore / uuid-ossp)、建 vector_store 表、建 HNSW 索引。开发环境开它,生产环境关掉——生产用 Flyway/Liquibase 管 DDL,别让应用启动时偷偷改表结构。
第 5 步:写入
vectorStore.add(chunks); // 内部自动调 EmbeddingModel,逐块转向量后批量插入
和上篇 accept() 是同一件事——VectorStore 接口统一了所有库的写入方式,这就是抽象的价值:哪天你真要从 PGVector 换 Milvus,业务代码一行不用动。
第 6 步:带过滤的检索
向量检索回答「语义上像不像」,元数据过滤回答「业务上合不合法」——比如只查某个租户的、某个版本的文档:
// 写法一:字符串表达式(SQL 风格,跨库可移植)
List<Document> docs = vectorStore.similaritySearch(
    SearchRequest.builder()
        .query("年假怎么折算")
        .topK(5)
        .similarityThreshold(0.5)
        .filterExpression("tenant == 'company' && version >= 2")
        .build());

// 写法二:FilterExpressionBuilder DSL(防手滑,推荐)
FilterExpressionBuilder b = new FilterExpressionBuilder();
List<Document> docs2 = vectorStore.similaritySearch(
    SearchRequest.builder()
        .query("年假怎么折算")
        .topK(5)
        .filterExpression(b.and(
            b.eq("tenant", "company"),
            b.gte("version", 2)).build())
        .build());
这套过滤表达式是 Spring AI 的可移植层:同一句 tenant == 'company',PGVector 把它翻译成 PostgreSQL 的 JSON path 查询,Elasticsearch 翻译成 query string,Milvus 翻译成标量过滤。学一次,全库通用。
四、五个坑,都是默认值惹的祸
- 坑 1:
initialize-schema默认 false。 2.0 的破坏性变更,1.x 是自动建表的。不开它,第一次add()直接报relation "vector_store" does not exist——报错信息倒是挺诚实。 - 坑 2:HNSW 索引 2000 维上限。 3072 维的 embedding 模型建不上 HNSW 索引。选模型之前先对一下维度表。
- 坑 3:dimensions 改了必须删表重建。 维度在建表时就写死在列定义里(
vector(1536)),换了模型不会自动迁移,写入直接报错。删表重建 + 全量重新向量化,跑不了。 - 坑 4:
remove-existing-vector-store-table=true会删表。 这参数配上initialize-schema=true,等于每次启动清空向量库。本地开发图省事可以开,连生产配置都敢开的,建议直接转行。 - 坑 5:metadata 列是 json 不是 jsonb。 过滤走 JSON path,数据量大 + 过滤条件复杂时会慢。高频过滤字段考虑单独建列。另外自定义 schema/table 名时开
schema-validation=true,防 SQL 注入也防手滑。
写在最后
选型的本质是分档:数据量定档位,运维能力定上限。 90% 的项目一张 Postgres 就够,PGVector 六步跑通,过滤表达式跨库可移植。把调研 Milvus 的两周省下来,去调切分策略,收益大十倍。
下一篇《第一个能跑的 RAG:QuestionAnswerAdvisor》——前三篇的所有零件(Reader、Splitter、VectorStore)终于要拼成一台整机:一个 Advisor 把「检索 + 拼提示词 + 调模型」全包了,五行代码出效果。
点个「在看」——选库这学费,咱们又替读者交了一回。
作者:老魏 · 一个把公众号和代码当副业的散户投资者 系列:Java RAG 从零到上线 · 第 5/10 篇 下期:第一个能跑的 RAG:QuestionAnswerAdvisor