Java RAG 合集⑦:RAG 的乐高积木——模块化 RAG 四段流水线
上一篇 QuestionAnswerAdvisor 五行代码跑通了 RAG,但你很快就发现不对劲:它是一台「一体机」——检索逻辑、拼提示词的方式、空结果怎么处理,全焊死在里面。想改?没门。
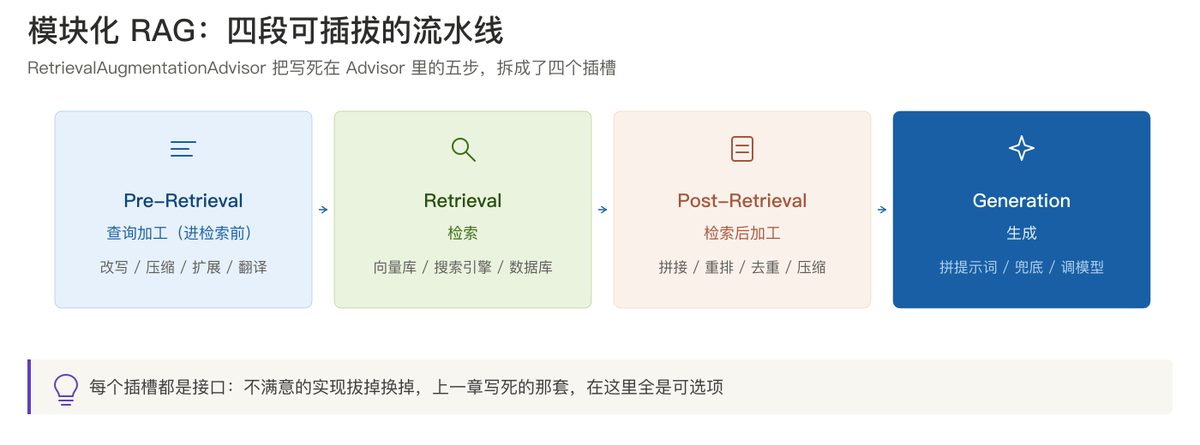
这一章把一体机拆开。Spring AI 提供了一台「模块化 RAG 流水线」:RetrievalAugmentationAdvisor,把 RAG 拆成四段,每段都是接口,每个零件都能换。
读完你应该能: - 说清模块化 RAG 的四段架构,每段管什么、能插什么 - 用查询改写解决多轮对话「这个小区是哪个小区」的指代问题 - 用多查询扩展一次从三个角度搜 - 搞懂空上下文兜底开关,别把它理解反了
一、四段流水线长什么样
先加依赖(又是一个新模块名,2.0 的模块拆得很细):
<dependency>
    <groupId>org.springframework.ai</groupId>
    <artifactId>spring-ai-rag</artifactId>
</dependency>
最小可用装配,是不是和上一篇眼熟?但每个环节现在都是显式声明的插槽:
Advisor ragAdvisor = RetrievalAugmentationAdvisor.builder()
    .documentRetriever(VectorStoreDocumentRetriever.builder()
        .vectorStore(vectorStore)
        .similarityThreshold(0.50)
        .topK(6)
        .build())
    .build();

String answer = chatClient.prompt()
    .advisors(ragAdvisor)
    .user("年假可以跨年吗?")
    .call()
    .content();
四段各管一摊:
- Pre-Retrieval(查询加工):用户的话直接拿去搜往往效果差——改写、压缩、扩展、翻译,都在这里做
- Retrieval(检索):从向量库、搜索引擎甚至数据库拿资料,
VectorStoreDocumentRetriever只是内置实现之一 - Post-Retrieval(检索后加工):多路检索结果怎么拼、怎么去重、怎么重排
- Generation(生成):资料拼进提示词的方式、空结果兜底话术
注意一个细节:这里的 topK 和阈值在 VectorStoreDocumentRetriever 上配,不是 SearchRequest——两套体系的参数长在不同的类上,混着找会找半天。
二、查询改写:多轮对话的救命稻草
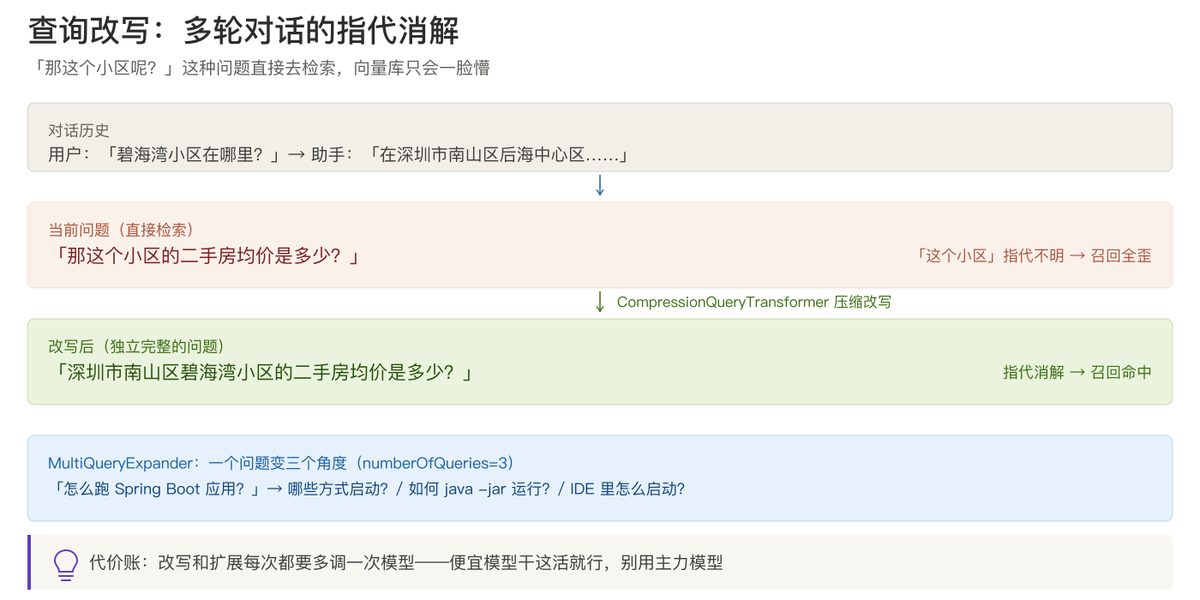
用户问「碧海湾小区在哪里?」你答了。接着他问「那这个小区的二手房均价是多少?」
这句话里「这个小区」指什么,人看得懂,向量库看不懂——「这个小区」四个字的向量和任何楼盘都对不上,召回全歪。上一章的 QuestionAnswerAdvisor 对此无能为力:它拿原文直接搜。
模块化 RAG 的解法:检索前先让模型把问题改写成独立完整的话。
Query query = Query.builder()
    .text("那这个小区的二手房均价是多少?")
    .history(new UserMessage("碧海湾小区在哪里?"),
             new AssistantMessage("碧海湾小区位于深圳市南山区后海中心区。"))
    .build();

QueryTransformer compressor = CompressionQueryTransformer.builder()
    .chatClientBuilder(chatClient.mutate())
    .build();

Query rewritten = compressor.transform(query);
// 「深圳市南山区碧海湾小区的二手房均价是多少?」
CompressionQueryTransformer 把对话历史和当前问题压缩成一句自包含的话,指代消解顺手就做了。类似 还有两个兄弟:
RewriteQueryTransformer:用户啰里啰嗦说一大段,重写成干脆的检索查询TranslationQueryTransformer:查询语言和知识库语言不一致时翻译(中文资料库遇到英文提问就用它)
三、多查询扩展:一次搜三个角度
同一个问题有 N 种问法。用户问「怎么跑 Spring Boot 应用?」,资料里写的可能是「启动」「运行」「部署」——只搜一次只能碰一种说法。
MultiQueryExpander expander = MultiQueryExpander.builder()
    .chatClientBuilder(chatClient.mutate())
    .numberOfQueries(3)
    .includeOriginal(false)
    .build();

List<Query> queries = expander.expand(new Query("怎么跑 Spring Boot 应用?"));
// → 「有哪些方式启动?」/「如何用 java -jar 运行?」/「IDE 里怎么启动?」
三个变体各自去检索,结果合并去重后召回率明显提升。注意 includeOriginal 默认是 true(保留原问题一起搜),想要纯扩展记得显式关。
代价账也要算清:改写和扩展每次请求都要多调一次模型——这活交给最便宜的模型就行,chatClient.mutate() 换个小模型,别拿主力模型干粗活。
四、检索不到东西时:兜底开关
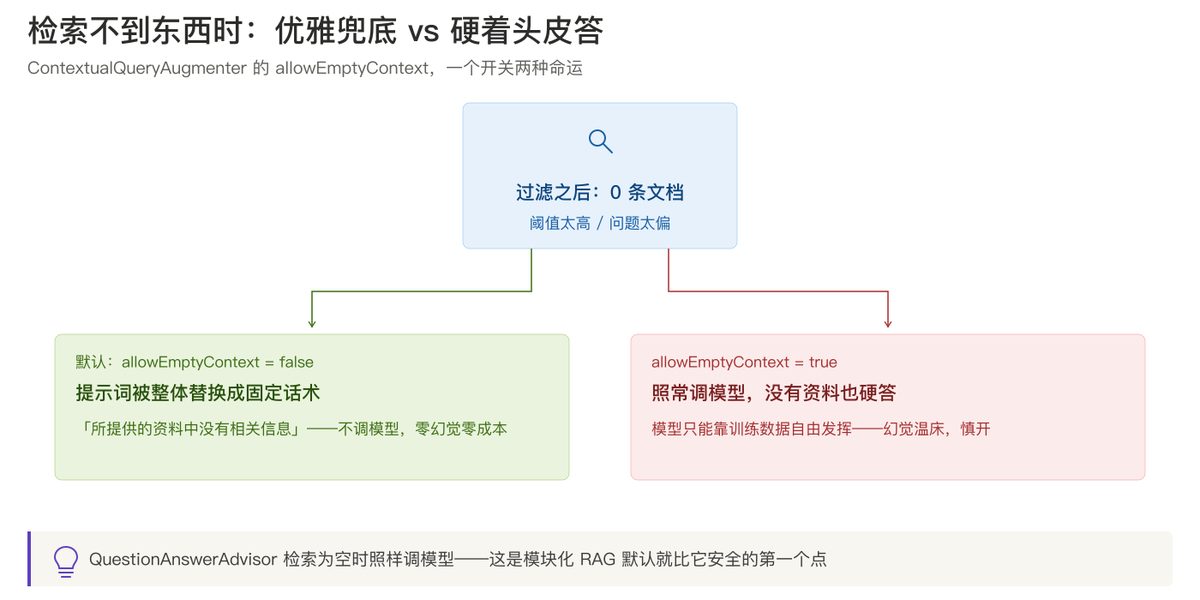
阈值设高了、问题太偏了,检索结果可能是 0 条。这时怎么办?ContextualQueryAugmenter 有个开关:
.queryAugmenter(ContextualQueryAugmenter.builder()
    .allowEmptyContext(false)   // 默认值
    .build())
默认是 false:检索为空时,提示词被整体替换成固定话术(大意是「所提供的资料中没有相关信息」),根本不调模型——零幻觉、零 token 成本。
设成 true 才是「没有资料也让模型硬答」。很多人凭直觉理解反了,以为 true 是「允许空上下文时报错」——恰恰相反,它是「允许空着也照答」。除非你的场景确实需要模型兜底闲聊,否则保持默认。
顺带说一句,上一篇的 QuestionAnswerAdvisor 检索为空时照样调模型硬答——这是模块化 RAG 默认就比它安全的第一个点。
五、Post-Retrieval:先卖个关子
多路检索的结果怎么拼、拼完怎么去重重排,RetrievalAugmentationAdvisor 用 DocumentJoiner 和 DocumentPostProcessor 两个插槽解决——而「重排」恰恰是检索质量第二次跃迁的关键,值得单独一章。下一篇《Rerank 与混合检索》专门讲。
六、坑位清单
- 坑 1:依赖名记混。 RAG 模块是
spring-ai-rag;QuestionAnswerAdvisor在spring-ai-vector-store-advisor。两个 Advisor 别同时挂同一个 ChatClient——会检索两次,钱白花还拖慢响应。 - 坑 2:topK 找错了地方。 模块化 RAG 的检索参数在
VectorStoreDocumentRetriever,不在SearchRequest。 - 坑 3:includeOriginal 理解反。 默认 true 保留原问题,false 才是纯扩展。
- 坑 4:allowEmptyContext 理解反。 默认 false 是「空了就用固定话术挡回去」(安全);true 是「空了也让模型硬答」(幻觉风险)。
- 坑 5:改写成本没算账。 每次改写、扩展都多一次模型调用,用便宜模型,并给改写环节设超时。
七、四段全开的完整装配
Advisor ragAdvisor = RetrievalAugmentationAdvisor.builder()
    // Pre-Retrieval:压缩多轮历史 + 扩展多角度
    .queryTransformers(CompressionQueryTransformer.builder()
        .chatClientBuilder(chatClient.mutate())
        .build())
    .queryExpander(MultiQueryExpander.builder()
        .chatClientBuilder(chatClient.mutate())
        .numberOfQueries(3)
        .build())
    // Retrieval:向量库,阈值 0.5 取 6 条
    .documentRetriever(VectorStoreDocumentRetriever.builder()
        .vectorStore(vectorStore)
        .similarityThreshold(0.50)
        .topK(6)
        .build())
    // Generation:空上下文走固定话术兜底
    .queryAugmenter(ContextualQueryAugmenter.builder()
        .allowEmptyContext(false)
        .build())
    .build();
挂上 ChatClient 之后,多轮对话的「这个小区呢」、偏门问题的空结果兜底,全都自动处理了。
写在最后
模块化的意义不是「功能多」,而是把「写死的决策」变成「可替换的策略」。四段流水线上每个插槽,都是一个可以在评测里 A/B 的变量——这正是下一篇调优的地基。
下一篇《Rerank 与混合检索》——向量召回会命中「语义相近但业务无关」的内容,两阶段检索(粗召回 Top20 → 精排 Top5)和 BM25 + 向量的混合检索,是检索质量第二次跃迁的两条腿。
点个「在看」——一体机拆成了积木,好日子还在后头。
作者:老魏 · 一个把公众号和代码当副业的散户投资者 系列:Java RAG 从零到上线 · 第 7/10 篇 下期:Rerank 与混合检索