Java RAG 合集⑧:先广撒网,再精挑细选——Rerank 与混合检索
上一篇把 RAG 拆成了四段积木,但地基还是那一条:检索质量。检索不行,后面三段全是白搭——垃圾进,垃圾出(第④篇的原话在这应验了)。
这一章讲检索质量的两次升级:两阶段精排和混合检索。这两招做完,RAG 答案的「准头」会有肉眼可见的跃迁——代价是延迟和账单,所以最后一节我们把账算清楚。
读完你应该能:
- 说清向量检索为什么会召回「语义相近但业务无关」的内容
- 用 DocumentPostProcessor 插槽接 Rerank,实现粗召回 Top-20 → 精排 Top-5
- 知道混合检索为什么该上,以及 Spring AI 为什么没内置、怎么自己搭
- 给这些提升算延迟和成本的账
一、向量检索的先天短板
先看病根。向量检索用的是双塔模型:问题和文档分别编码成向量,比余弦距离。它的好处是文档可以离线编码、检索时只算一次问题向量——快,能从百万级文档里毫秒级捞人。
代价是:问题和文档在编码时从没见过面。「试用期年假怎么算」和《员工手册》总则里的「年假相关制度说明」语义确实相近,双塔模型分不清哪个才是真答案——它们只是「在向量空间里挨得近」。
所以你会经常遇到这种情况:召回的文档都沾点边,但真正能回答问题的那条,排在第 3 甚至第 5。前面全是高分噪声,全塞给模型,注意力被稀释,答案质量打折。
二、两阶段:粗召回 + 精排
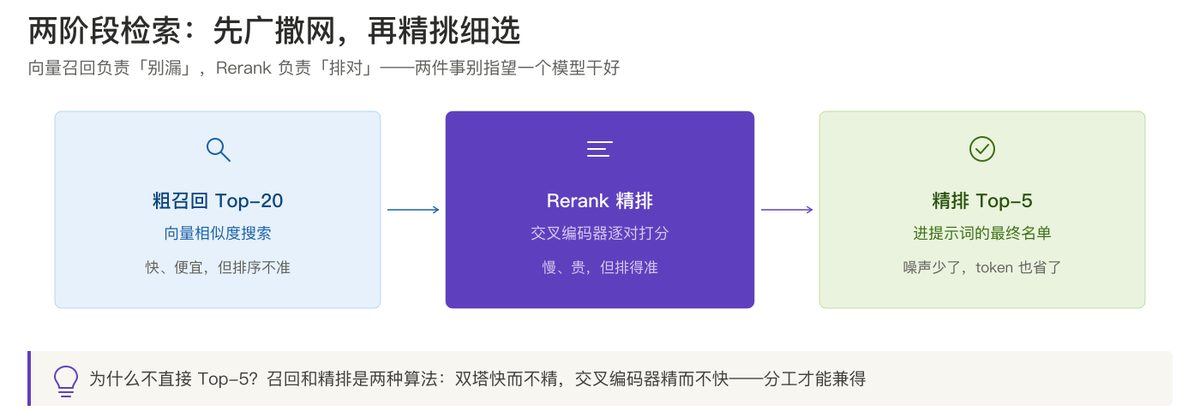
解法是分工:召回阶段不追求排得准,只求别漏(Top-20);精排阶段用一个更重的模型,把 20 条排成 5 条。
精排用的交叉编码器和双塔完全不同:问题和文档拼在一起送进模型,逐对细算相关度。准得多,但也慢得多——所以只能伺候 20 条,伺候不起全库。
Spring AI 把这个环节做成了第⑦篇介绍过的 DocumentPostProcessor 插槽。Rerank 本身框架没内置(各家 API 形态不一),自己接一个很直接:
public class RerankPostProcessor implements DocumentPostProcessor {

    private final RerankClient rerankClient;   // 封装你的 Rerank API 调用

    @Override
    public List<Document> process(Query query, List<Document> documents) {
        if (documents.size() <= 5) {
            return documents;   // 本来就不多,不值得精排
        }
        // 1. 问题和 20 条文档逐对送进 Rerank API 打分
        List<ScoredDocument> scored =
            rerankClient.score(query.text(), documents);
        // 2. 按相关度重排,留前 5
        return scored.stream()
            .sorted(Comparator.comparing(ScoredDocument::score).reversed())
            .limit(5)
            .map(ScoredDocument::document)
            .toList();
    }
}
Cohere、Jina、智谱、硅基流动都有现成的 Rerank API,选一个延迟低的(国内服务通常 50~150ms 能跑完 20 条)。装配时挂上就行:
Advisor ragAdvisor = RetrievalAugmentationAdvisor.builder()
    .documentRetriever(VectorStoreDocumentRetriever.builder()
        .vectorStore(vectorStore)
        .topK(20)                  // 粗召回放宽
        .similarityThreshold(0.3)  // 阈值相应调低,别在粗排就把人拒了
        .build())
    .documentPostProcessors(new RerankPostProcessor(rerankClient))
    .build();
注意粗召回的阈值要跟着调:Top-20 的使命是「别漏」,阈值设 0.6 会把正确答案挡在门外,精排再准也救不回来。
三、Rerank 前后,差在哪
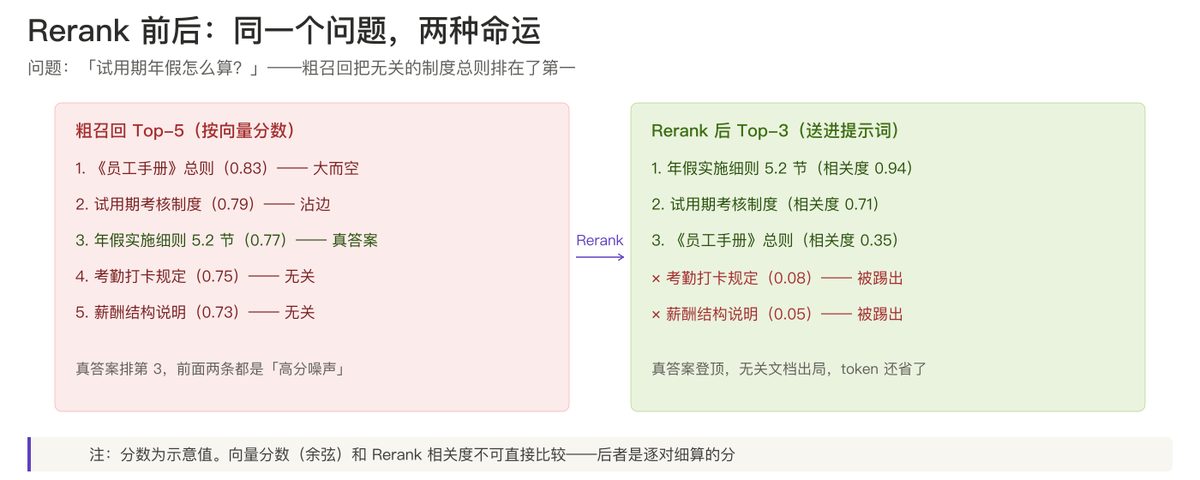
看这组对比:同一个问题「试用期年假怎么算」,粗召回把大而空的《员工手册》总则排在第一,真答案《年假实施细则》5.2 节排在第三。全塞给模型,模型大概率照着总则泛泛而谈。
Rerank 之后:真答案登顶(相关度 0.94),两条无关文档直接出局。进提示词的不仅更准,还更少——token 账省下来了。
还有个容易踩的坑:向量分数和 Rerank 相关度是两套分数,不可直接比较。余弦 0.83 不代表比 Rerank 的 0.35 更相关——前者是几何距离,后者是逐对细算的相关性概率。别用一套阈值去卡另一套的输出。
四、混合检索:语义和关键词两条腿
Rerank 解决「排得准」,但「漏」的问题还得靠召回端——特别是这一类查询:
ERR_CODE_10086 报什么错?
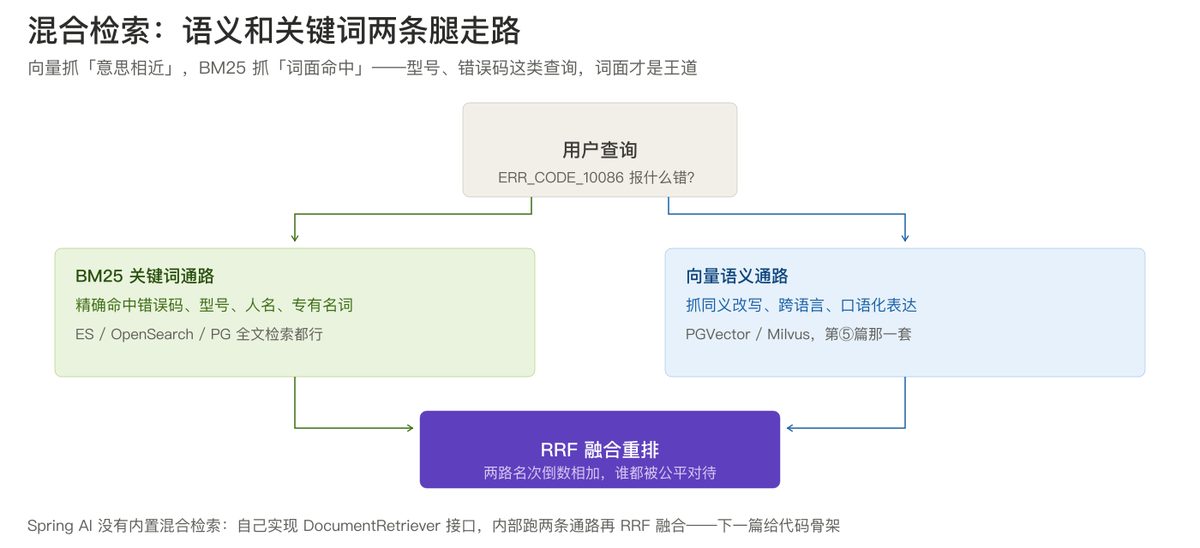
错误码、型号、人名、专有名词——这些 token 的向量没有语义可循,向量检索经常捞不准;但 BM25 这类关键词检索对词面命中一击必杀。反过来,口语化的「电脑开不了机咋整」,关键词检索又干不过向量。两条腿各有一条盲区,且互补。
先泼冷水:Spring AI 没有内置混合检索。网上有些文章会给你一个 HybridRetriever.builder().weight(0.7, 0.3) 的写法——查遍官方文档也没有这个类,照抄必报错。正确姿势是自己实现 DocumentRetriever 接口,内部跑两条通路再融合:
public class HybridRetriever implements DocumentRetriever {

    private final VectorStore vectorStore;
    private final Bm25Searcher bm25;   // ES / OpenSearch / PG 全文检索

    @Override
    public List<Document> retrieve(Query query) {
        // 两路各自召回 Top-20
        List<Document> dense = vectorStore.similaritySearch(
            SearchRequest.builder().query(query.text()).topK(20).build());
        List<Document> sparse = bm25.search(query.text(), 20);

        return rrfFuse(dense, sparse);   // RRF 融合
    }

    /** Reciprocal Rank Fusion:按名次倒数融合,k 取 60 是惯例 */
    private List<Document> rrfFuse(List<Document> a, List<Document> b) {
        Map<Document, Double> score = new HashMap<>();
        for (List<Document> list : List.of(a, b)) {
            for (int i = 0; i < list.size(); i++) {
                score.merge(list.get(i), 1.0 / (60 + i + 1), Double::sum);
            }
        }
        return score.entrySet().stream()
            .sorted(Map.Entry.<Document, Double>comparingByValue().reversed())
            .limit(20)
            .map(Map.Entry::getKey)
            .toList();
    }
}
RRF(倒数排名融合)的好处是不需要把两路分数归一化——只看名次,谁在自家通路排得靠前谁得分高,简单稳健,是业界默认做法。
混合检索之后接 Rerank 精排,效果叠加:召回端「该来的都来了」,精排端「该排前的排前面」。公开评测里,混合检索相对纯向量召回常见两位数的指标提升,数据形态越偏「术语型」提升越大。
五、延迟与成本的账
好处说完,把账摆开:
- 粗召回放宽到 Top-20:向量库本来就能扛,几乎零成本
- BM25 通路:多一次 ES/PG 查询,10~30ms,便宜
- Rerank API:20 条文档一次调用,50~150ms,按次收费——这是最贵的一段
- 提示词更短:精排后只送 5 条,模型侧 token 反而省了
结论:问答延迟预算够(比如客服场景 3 秒内),闭眼上;对延迟敏感的搜索联想类场景,先只上混合检索(便宜),Rerank 酌情。 Rerank 别配太大的粗召回池——20 条是延迟和效果的平衡点,上到 50 条延迟翻倍,收益递减。
六、坑位清单
- 坑 1:粗召回阈值忘了降。 Top-20 配 0.6 阈值 = 精排再准也白搭,正确答案进不了候选池。
- 坑 2:照抄网上的 HybridRetriever。 Spring AI 没有这个类,官方文档查无此 API,自己实现
DocumentRetriever才是真的。 - 坑 3:两套分数混着比。 向量余弦分和 Rerank 相关度不可比,各自的阈值各管各的段。
- 坑 4:中文 BM25 没分词。 ES 装 smartcn/ik 分词器,否则中文按字切,BM25 效果腰斩。
- 坑 5:Rerank 池子贪大。 20 条足够,50 条延迟翻倍收益递减,账算不过来。
七、完整装配
两阶段 + 混合检索全开:
Advisor ragAdvisor = RetrievalAugmentationAdvisor.builder()
    // Retrieval:换成自研混合检索器
    .documentRetriever(new HybridRetriever(vectorStore, bm25Searcher))
    // Post-Retrieval:Rerank 精排 Top-20 → Top-5
    .documentPostProcessors(new RerankPostProcessor(rerankClient))
    // Generation:空结果兜底(第⑦篇)
    .queryAugmenter(ContextualQueryAugmenter.builder()
        .allowEmptyContext(false)
        .build())
    .build();
写在最后
这一章的优化都是「拍脑袋调不出对错」的——Top-20 还是 Top-30?阈值 0.3 还是 0.4?上不上 Rerank?每一刀都得靠数据说话。
下一篇《别再凭感觉调参:RAGAS 四维指标与 Java 实现》——给 RAG 装上仪表盘:Faithfulness、Answer Relevancy、Context Precision、Context Recall 四个指标,用 ChatClient 手写 LLM-as-Judge 评判器,让每次调参都有数可依。
点个「在看」——广撒网和精挑细选,从来都是两门手艺。
作者:老魏 · 一个把公众号和代码当副业的散户投资者 系列:Java RAG 从零到上线 · 第 8/10 篇 下期:RAGAS 四维指标与 Java 实现