Java RAG 合集⑨:别再凭感觉调参了——RAGAS 四维指标与 Java 实现
前八章我们做了不少决策:topK 给多少、阈值设多高、上不上 Rerank、切分参数怎么配。这些决策你是怎么验证的?大多数人的答案是三个字:看感觉。改完跑两句试试,「嗯,好像好点了」,收工。
这不叫调参,这叫算命。这一章给 RAG 装上仪表盘:四个指标 + 一个可自动跑的评判器,让每次改动都有数可依。
读完你应该能: - 理解 RAGAS 四维指标分别在问什么问题 - 用 ChatClient 手写一个 LLM-as-Judge 评判器(Spring AI 没有内置评估框架,自己搭不难) - 按指标定位流水线短板,而不是瞎调 - 把评测挂进回归测试,改代码不再裸奔
一、先有评测集,再谈指标
指标都是对着一堆「问答样例」算的,所以第一步是攒评测集:
- 规模:20~50 条就够起步,重要的是覆盖面不是数量
- 每条三要素:用户问题 + 标准答案(人工写)+ 元信息(属于哪类问题)
- 必须包含刁钻样例:带错别字的、知识库里没有的(超纲)、多轮指代的——评测集太干净,测出来的全是幻觉里的高分
标注 50 条大概要一个下午,这是 RAG 项目里回报率最高的一个下午。
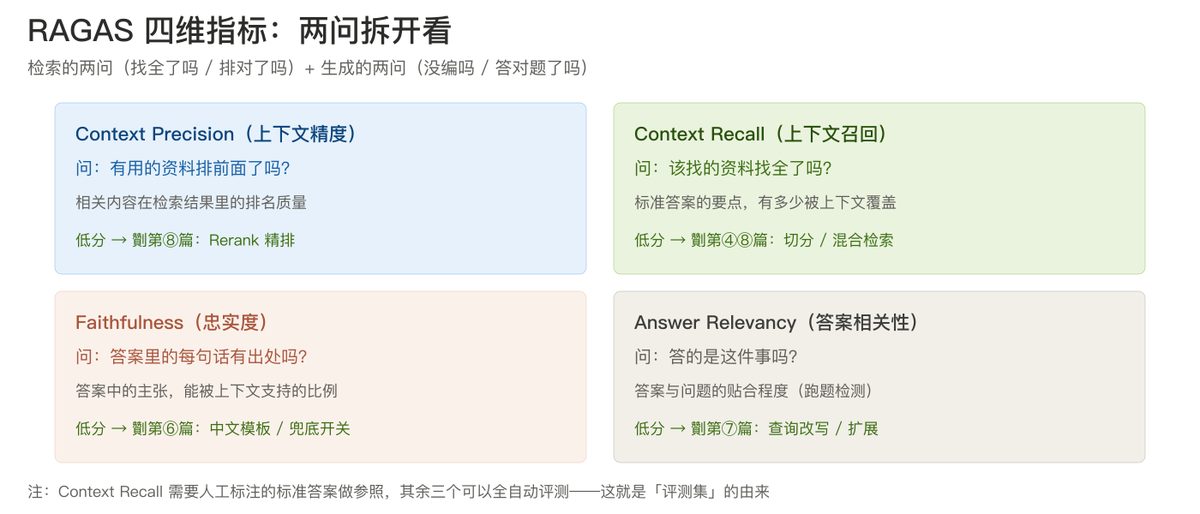
四个指标四问,两两对应流水线的两段:
- 检索侧:Context Recall(找全了吗)→ Context Precision(有用的排前面了吗)
- 生成侧:Faithfulness(没编吗)→ Answer Relevancy(答对题了吗)
二、LLM-as-Judge:让模型当阅卷老师
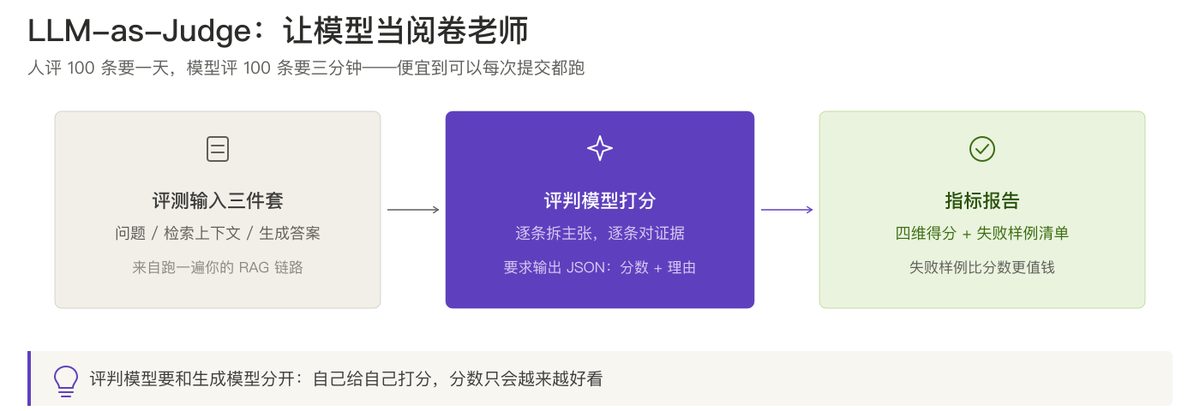
四个指标里,除了 Context Recall 需要对标准答案做覆盖判断,其余全部可以用「让一个更强的模型来打分」的方式自动化——这就是 LLM-as-Judge:把问题、检索上下文、生成答案喂给评判模型,让它拆主张、对证据、输出分数和理由。
人评 100 条要一天,模型评 100 条要三分钟、几块钱——便宜到可以每次提交代码都跑一遍。
Spring AI 没有内置评估框架,但用 ChatClient 手写一个不难。以 Faithfulness(忠实度)为例,原理是三步:从答案里拆出一条条主张,逐条判断有没有上下文依据,算支持比例:
public class FaithfulnessJudge {

    private final ChatClient judgeClient;   // 注意:用另一个模型

    /** 返回 0~1,越高越忠实 */
    public double score(String question, String context, String answer) {
        String verdict = judgeClient.prompt()
            .user("""
                你是严格的审阅员。逐条判断下面的回答是否忠于参考资料,
                资料里没有依据的说法一律算「无依据」。

                参考资料:
                ---------------------
                %s
                ---------------------

                回答:%s

                只输出 JSON,不要输出别的:
                {"supported": ["有依据的主张..."], "unsupported": ["无依据的主张..."]}
                """.formatted(context, answer))
            .call()
            .content();

        JudgeResult r = parse(verdict);   // 解析 JSON,解析失败重试一次
        int s = r.supported().size();
        int u = r.unsupported().size();
        return s + u == 0 ? 1.0 : (double) s / (s + u);
    }
}
另外三个指标同思路换 prompt:
- Answer Relevancy:让模型「根据这个答案反向生成 N 个可能的问题」,算这些问题和原问题的相似度——答案跑题,反向问题就对不上
- Context Precision:让模型对每条检索文档标注「对回答这个问题有用吗」,看有用的是否排在前面
- Context Recall:把标准答案拆成要点,逐条问「上下文里能找到支撑吗」,算覆盖比例
三、哪个指标低,修哪段
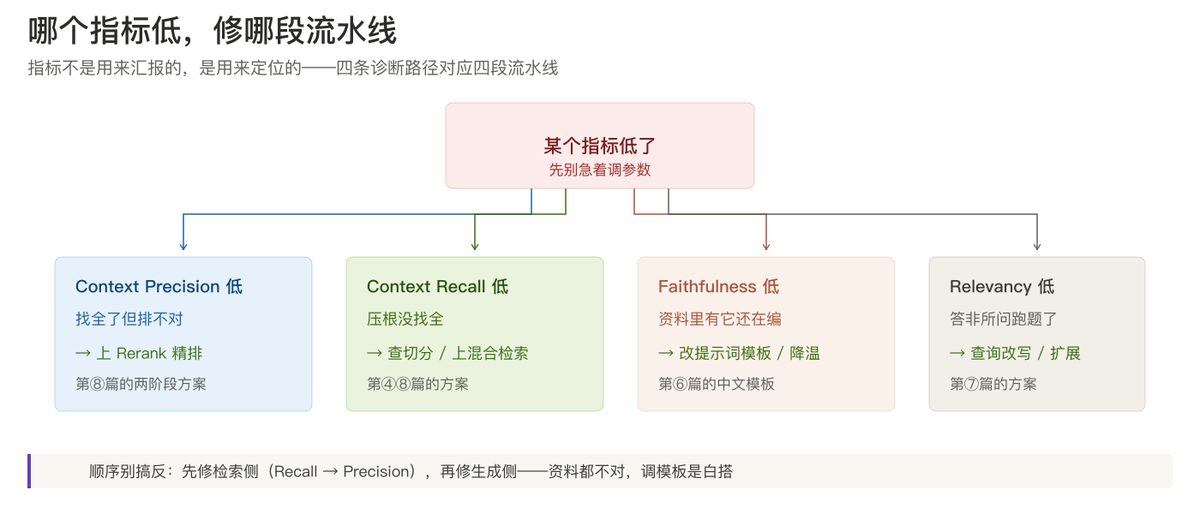
指标的价值不在分数本身,在定位。四个低分对应四条诊断路径,而且顺序有讲究:
- Context Recall 低 → 根都没找全,查第④篇的切分策略、上第⑧篇的混合检索
- Context Precision 低 → 找到了但排序乱,上 Rerank 精排
- Faithfulness 低 → 资料里有它还在编,改第⑥篇的提示词模板、调低 temperature
- Answer Relevancy 低 → 答非所问,回第⑦篇做查询改写
先检索侧后生成侧——资料都不对,改模板、换模型全是白搭。这条顺序能帮你省下大量「调了三天没变化」的时间。
四、挂进回归测试
评测真正的威力是当回归门禁用:
@Test
void ragQualityShouldNotRegress() {
    List<Case> cases = loadEvalSet("eval/cases.json");   // 50 条评测集
    double faithfulness = cases.stream()
        .mapToDouble(c -> runAndJudge(c).faithfulness())
        .average().orElse(0);
    double relevancy = cases.stream()
        .mapToDouble(c -> runAndJudge(c).relevancy())
        .average().orElse(0);

    assertThat(faithfulness).isGreaterThanOrEqualTo(0.85);
    assertThat(relevancy).isGreaterThanOrEqualTo(0.80);
}
从此改切分参数、换 embedding 模型、动提示词,跑一下测试就知道有没有把别的问题改坏。阈值别定 0.95——RAG 评测的随机性不小,定太高天天误报,团队很快就会把这套流程扔掉。0.8 左右起步,随基线收紧。
五、坑位清单
- 坑 1:评判模型用生成模型自己。 自己给自己打分只会越来越好看,judge 必须换一个模型(或至少换一套 prompt 身份)。
- 坑 2:生成环节 temperature 没固定。 评测要可复现,跑评测时 temperature 设 0,否则分数天天漂。
- 坑 3:只看总分。 平均分 0.87 可能是「50 条全 0.87」也可能是「45 条满分 + 5 条崩了」——失败样例清单比分数值钱,逐条看。
- 坑 4:judge 输出的 JSON 没兜底。 评判模型偶尔会不守规矩输出解释文字,解析失败要重试,别让评测脚本崩在第 37 条。
- 坑 5:拿 LLM 打分当绝对真理。 Judge 有偏差(偏爱长答案、偏爱自家风格),指标用来对比「改动前后」,不用来当绝对质量承诺。
六、完整评测流水线骨架
// 1. 逐条跑 RAG 链路,拿到 上下文 + 答案
// 2. 四个 Judge 分别打分
// 3. 汇总 + 输出失败样例
EvaluationReport report = cases.stream()
    .map(c -> {
        RagResult r = ragPipeline.run(c.question());   // 你的完整链路
        return new CaseScore(
            c.id(),
            faithfulnessJudge.score(c.question(), r.context(), r.answer()),
            relevancyJudge.score(c.question(), r.context(), r.answer()),
            precisionJudge.score(c.question(), r.context()),
            recallJudge.score(c.question(), r.context(), c.groundTruth())
        );
    })
    .collect(EvaluationReport.collector());

report.printFailedCases(System.out);   // 失败样例逐条打出来
写在最后
有了仪表盘,前面八章的所有决策——topK、阈值、Rerank、混合检索、查询改写——从「玄学」变成了「可以量化对比的实验」。这就是这一章排在调优章节后面的原因:没有指标的调优,只是换个姿势玄学。
收官篇《上线:安全、性能、成本与可观测》——从开发环境到生产环境的最后一公里:CVE 清单、Prompt 注入、多租户隔离、语义缓存、Micrometer 埋点,外加一份可以直接抄的上线 Checklist。
点个「在看」——从此调参不再看感觉。
作者:老魏 · 一个把公众号和代码当副业的散户投资者 系列:Java RAG 从零到上线 · 第 9/10 篇 下期:上线:安全、性能、成本与可观测