Java RAG 合集②:版本选择的血泪史,Spring AI 2.0 从搭建到第一个流式调用
写这篇的时候我去翻了一下网上还在教的 Spring AI 教程——90% 还在讲 1.1.x,配置属性还带 .options,模块名还是 spring-ai-advisors-vector-store。
但 Spring AI 2.0.0 已经在 2026 年 6 月 12 日 GA,2.0.1(2026-08-21)是当前稳定版。Spring Boot 3.5 / Spring Framework 6.2 2026-06-30 EOL——也就是说,照那些教程写出来的东西,三分之一的依赖已经没安全补丁了。
这篇是实操开篇:怎么选版本、怎么钉版本、第一个同步 + 流式调用、国内模型怎么接、还有 5 个 2.0 升级必踩的坑。全程 Spring AI 2.0.1 + Boot 4.1 + Java 21。
一、为什么版本选择是血泪史
2024 年底你立项的时候,选了 Spring AI 1.0.x。2025 年你照着教程升级到 1.1.x。2026 年初你想再升一档——打开官网一看,2.0 GA 了,1.1 只剩 1.1.7 一个维护版本,Boot 3.5 已经 EOL。
你面对的不是"升不升"的问题,而是升错了怎么办:
- 抄了 1.x 的配置跑不起来(
.options段被砍了) - 升级了 Boot 但漏了一个 starter,编译报
NoSuchMethodError - 配 DeepSeek / 通义千问的 base-url,直接 404,报错信息完全不告诉你哪里错了
- ChatOptions 传参类型变了(传 Builder 不传实例)
- 工具调用整层搬到 Advisor,旧代码要重写
每一条都是调试一下午的级别。这篇把这五条一次讲透,抄作业就行。
二、技术栈怎么选:三种情况,三个答案
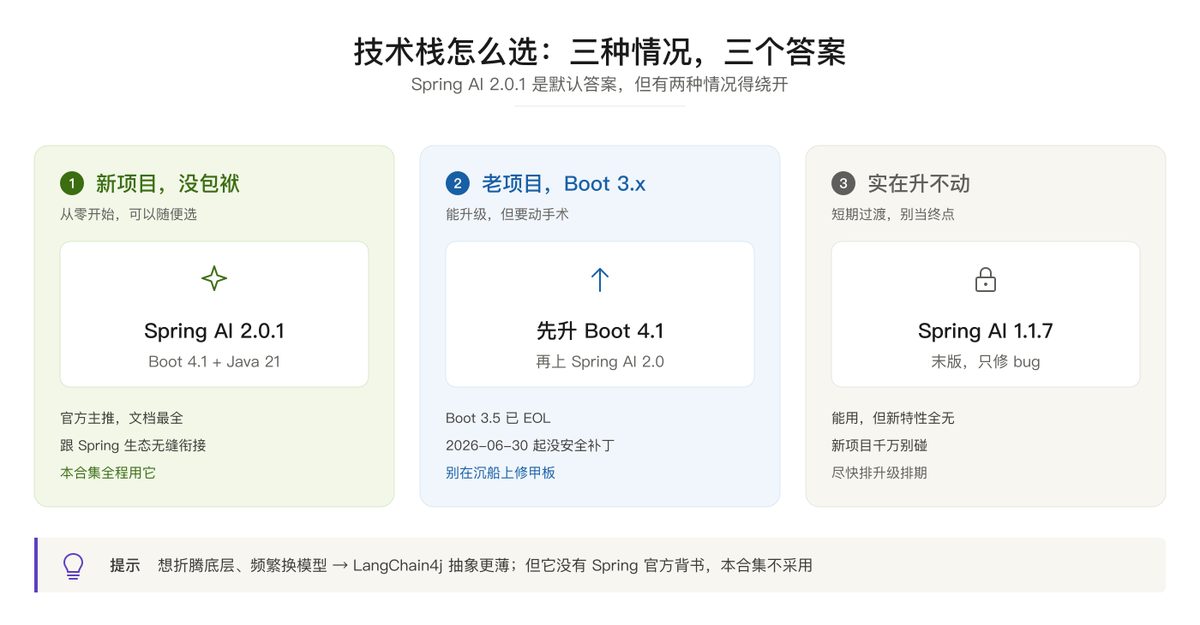
不是所有项目都该用最新版。新项目没包袱直接上 2.0.1,老项目要看能不能升 Boot,升级困难的才退守 1.1.7。
| 你的项目 | 怎么选 |
|---|---|
| 新项目 / 重构 | Spring AI 2.0.1——官方主推,文档最全,跟 Spring 生态无缝 |
| 老项目,Boot 3.x 能升级 | 先升 Boot 4.1,再上 2.0——Boot 3.5 已 EOL(2026-06-30),无安全补丁 |
| 老项目,升不动 | Spring AI 1.1.7——末版,只修 bug;用完赶紧排升级排期 |
不推荐 LangChain4j:抽象更薄、更灵活,但没有 Spring 官方背书。社区版图小、生产案例少、文档比 Spring AI 薄一半。本合集全程不采用。
三、钉版本:BOM 是底线
不管选哪一版,必须用 BOM 钉版本。散装版本 = 编译报 NoSuchMethodError,这个错在 Spring AI 2.0 出现概率比 1.x 高三倍——因为 2.0 模块切得更细,starter、advisor、rag、client-chat 都是独立 artifact,散装很容易配出"两个模块版本号不匹配"的组合。
pom.xml:
<dependencyManagement>
    <dependencies>
        <dependency>
            <groupId>org.springframework.ai</groupId>
            <artifactId>spring-ai-bom</artifactId>
            <version>2.0.1</version>
            <type>pom</type>
            <scope>import</scope>
        </dependency>
        <dependency>
            <groupId>org.springframework.boot</groupId>
            <artifactId>spring-boot-dependencies</artifactId>
            <version>4.1.0</version>
            <type>pom</type>
            <scope>import</scope>
        </dependency>
    </dependencies>
</dependencyManagement>

<dependencies>
    <dependency>
        <groupId>org.springframework.boot</groupId>
        <artifactId>spring-boot-starter-web</artifactId>
    </dependency>
    <dependency>
        <groupId>org.springframework.ai</groupId>
        <artifactId>spring-ai-starter-model-openai</artifactId>
        <!-- 不写 version,由 BOM 统一钉 -->
    </dependency>
</dependencies>
BOM(Bill of Materials)= 一组依赖的"版本清单"。只要 import 进 dependencyManagement,所有 Spring AI 模块的版本就被统一钉死,你就不用一个一个写 <version>。这是 Spring AI 2.0 唯一推荐的依赖管理方式。
starter 命名规则:spring-ai-starter-model-{provider}。OpenAI 就是 spring-ai-starter-model-openai,要接 Anthropic 就换成 spring-ai-starter-model-anthropic,核心 API 完全一样,换 starter 不动业务代码。
四、第一个同步调用:Hello World
application.properties:
spring.ai.openai.api-key=${OPENAI_API_KEY:sk-local-placeholder}
spring.ai.openai.base-url=${OPENAI_BASE_URL:https://api.openai.com/v1}
spring.ai.openai.chat.model=${OPENAI_MODEL:gpt-4o-mini}
API Key 放环境变量,不要写死在 properties。${VAR:default} 写法允许给个本地默认值,CI/生产环境用真实值覆盖。
Java 代码——Spring Boot 自动注入 ChatClient.Builder,你只需要 build() 一下:
@RestController
class HelloController {
    private final ChatClient chatClient;

    HelloController(ChatClient.Builder builder) {
        this.chatClient = builder.build();
    }

    @GetMapping("/ai")
    String hello(String q) {
        return chatClient.prompt()
                .user(q)
                .call()        // 同步调用
                .content();    // 拿 String
    }
}
启动 → 访问 http://localhost:8080/ai?q=讲个笑话 → 等 3-8 秒 → 一股脑返回全部。
.prompt().user(q).call().content() 是整个 Spring AI 的核心链式 API。记住这个形态,后面所有 RAG、工具调用、对话记忆都是在这个链上挂 Advisor。
但——用同步还是流式,看你的场景。下面见。
五、第一个流式调用:差一行代码,体验差一个时代
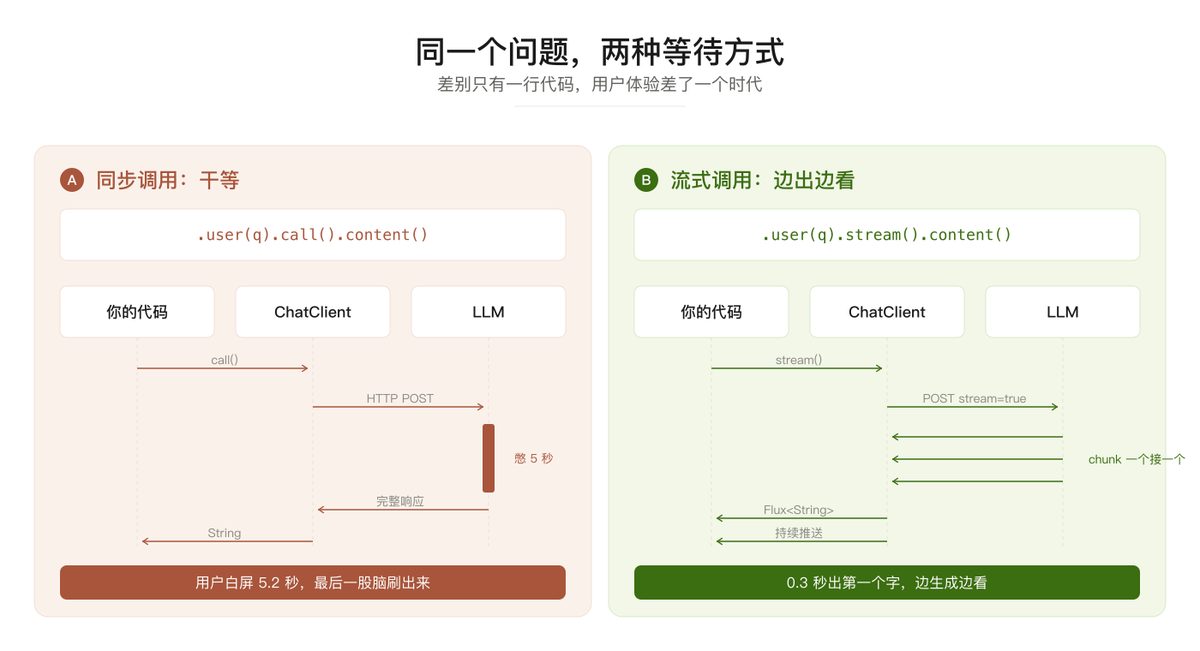
同步:用户白屏 5 秒,最后一次性刷出来——用户以为页面卡了。 流式:0.3 秒出第一个字,边生成边看——用户以为你在"打字"给他。
差别只有一行:.call() → .stream(),返回类型从 String 变成 Flux<String>。
@GetMapping(value = "/ai/stream", produces = MediaType.TEXT_EVENT_STREAM_VALUE)
Flux<String> stream(String q) {
    return chatClient.prompt()
            .user(q)
            .stream()       // 流式调用
            .content();      // Flux<String>,每产生一个 token 就推一次
}
WebFlux 工程直接接 SSE / WebSocket。Spring MVC 工程需要先用 produces = MediaType.TEXT_EVENT_STREAM_VALUE 告诉 Spring "这流是 EventStream",否则浏览器拿不到。
坑:流式调用别忘了
.content()。不写.content()返回的是Flux<ChatResponse>,每条 chunk 包了一层元数据,业务代码用String的话写getResult().getOutput().getText()——能用但丑。
六、国内模型怎么接:OpenAI 兼容 + 1 个字符的坑
DeepSeek、通义千问、Kimi、智谱 GLM,几乎所有国产 LLM 都兼容 OpenAI 接口协议。也就是说,你用 spring-ai-starter-model-openai 这个 starter 就能接它们——根本不用换 starter。
application.properties 三行搞定切换:
# DeepSeek
spring.ai.openai.api-key=${DEEPSEEK_API_KEY}
spring.ai.openai.base-url=https://api.deepseek.com/v1
spring.ai.openai.chat.model=deepseek-chat

# 通义千问 DashScope(OpenAI 兼容模式)
spring.ai.openai.api-key=${DASHSCOPE_API_KEY}
spring.ai.openai.base-url=https://dashscope.aliyuncs.com/compatible-mode/v1
spring.ai.openai.chat.model=qwen-plus

# 智谱 GLM
spring.ai.openai.api-key=${ZHIPU_API_KEY}
spring.ai.openai.base-url=https://open.bigmodel.cn/api/paas/v4
spring.ai.openai.chat.model=glm-4-plus
业务代码完全不用改——换模型就是改 3 行配置。
⚠️ 1 个字符的坑(最容易踩):
base-url必须以/v1结尾。Spring AI 2.0 改用官方openai-javaSDK,SDK 只会在 base-url 后面拼chat/completions,不会再帮你拼/v1。你写https://api.deepseek.com(少/v1),SDK 会拼成https://api.deepseek.com/chat/completions——直接 404,而且报错信息完全不说"路径不对"。
老代码抄过来的同学,第一步就是检查 base-url 是不是有 /v1。这条比 BOM 错误还常见,能查一下午。
七、配置扁平化的 5 个雷:抄这张表就够了
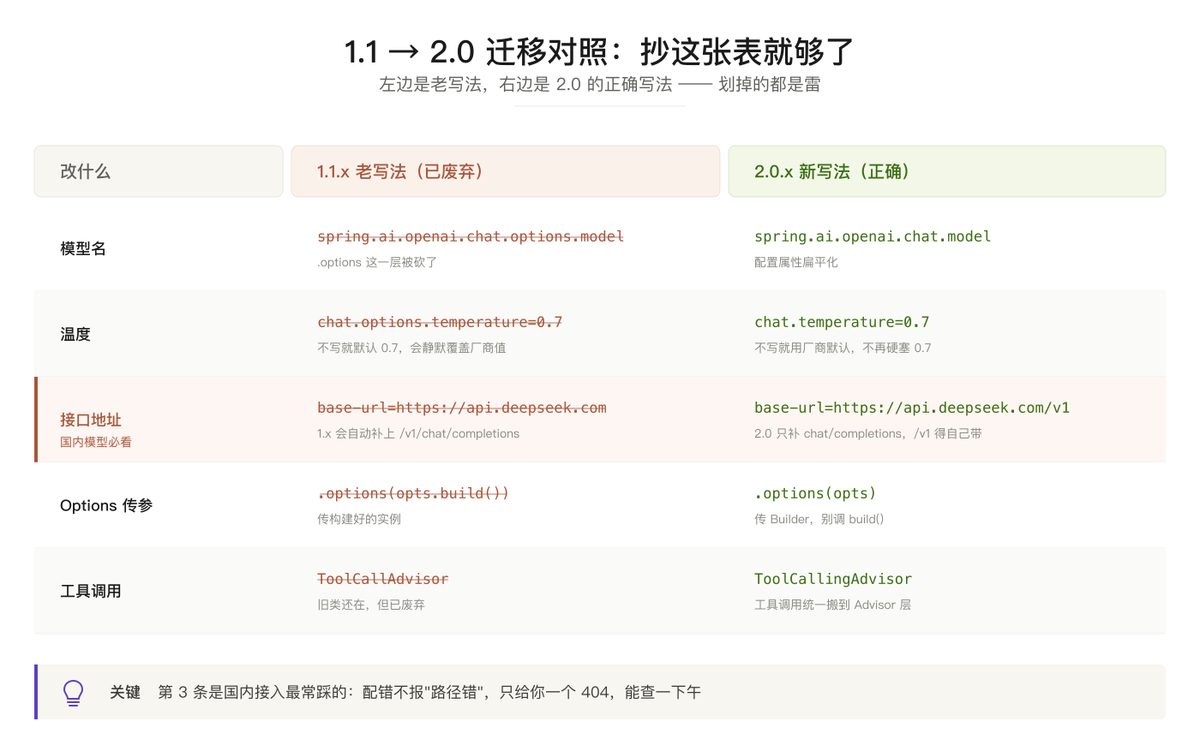
2.0 的配置体系砍掉了 .options 这一层、把 ChatOptions 改成 Builder 模式、迁移到各厂商官方 SDK。这些是网上 90% 教程还教错的地方。下面这份清单你截图保存(配置项都省略了 spring.ai.openai 前缀):
① 模型名
- 1.1(已废弃):
chat.options.model - 2.0(正确):
chat.model
② 温度
- 1.1:
chat.options.temperature=0.7(不写就默认 0.7) - 2.0:
chat.temperature=0.7(不写就用厂商默认)
③ OpenAI 地址
- 1.1:
base-url=https://api.deepseek.com(自动补/v1/chat/completions) - 2.0:
base-url=https://api.deepseek.com/v1(必须自带/v1,只补chat/completions)
④ Options 传参
- 1.1:
.options(opts.build())传构建好的实例 - 2.0:
.options(opts)传 Builder,别调build()
⑤ 工具调用
- 1.1:
ToolCallAdvisor(旧类已废弃) - 2.0:
ToolCallingAdvisor(工具调用统一搬到 Advisor 层)
最后两条特别反直觉:
.options()传 Builder 不传实例:1.x 习惯OpenAiChatOptions.builder().temperature(0.7).build()拿到实例再传,2.0 直接传 builder,build()反而会报错(Builder 设计成不可变,必须在最后一步才 build)。看起来像少打了一次build(),其实是故意的。- 温度不再有默认值:1.x Spring AI 默认 0.7,会静默覆盖 OpenAI/Anthropic 的厂商默认。2.0 不设就用厂商默认。好处是你不再被默认值绑架,坏处是你以为的 0.7 其实没生效(1.x 同学会迷惑)。要固定行为就显式写温度。
八、老项目升级路径
如果你接手的是 1.1.x 老项目,按这五步走,能少踩一半坑:
- 先升 Spring Boot 到 4.1.x(不要 4.0,老版本 4.0.0 有几个 4.0.x 修了的关键 bug)
- 引入 spring-ai-bom 钉死 2.0.1(强烈建议先再动业务代码,依赖树先稳)
- application.properties 全量改造:
.options段全部去掉(用 IDE 全局搜索\.options+ 替换) - base-url 加
/v1(最容易漏,老项目配里大概率没带) .options(xxx.build())改.options(xxx)(全局搜索 + 替换,几秒钟)ToolCallAdvisor改名ToolCallingAdvisor(如果用了)
不要做的事:
- 别想着 1.1.x 和 2.0.x 共存(两套依赖会起冲突,BOM 也钉不住)
- 别先动业务代码再升依赖(错误信息会互相覆盖,难定位)
写在最后
这一篇没碰 RAG 本身——先把"能跑起来"的环境搭好。
下一篇《向量到底是个啥》,我们讲 Embedding 和相似度。RAG 检索靠的就是相似度匹配——"猫坐在垫子上"和"猫科动物趴在地毯上"为什么能被匹配上?Embedding 是怎么把一句话变成一串数字的?这些不讲清楚,第五篇讲向量库选型时你只会跟着别人配,看不懂参数。
点个"在看"——RAG 这条路很长,咱们一篇一篇扎实推进。
作者:老魏 · 一个把公众号和代码当副业的散户投资者 系列:Java RAG 从零到上线(Spring AI 2.0.1) 下期:向量到底是个啥:Embedding 与相似度(人话版)