Java RAG 合集③:向量到底是个啥,把一句话变成一串数字
上篇我们讲了 RAG 的全景和"为什么"。但 RAG 真正在干的事,其实就是——把一句话变成一串数字,然后在数字世界里找"近"的那个。
这一篇不写大段数学,用人话把这个事讲透。读完你应该能:
- 解释"猫坐在垫子上"和"猫科动物趴在地毯上"为什么能被匹配
- 知道余弦相似度是怎么算的、为什么不是欧氏距离
- 看懂 768 / 1024 / 1536 维背后的代价
- 跑通 Spring AI 的 EmbeddingModel 第一个调用,打印出向量来亲眼看看
一、把语义变成坐标:Embedding 的直觉
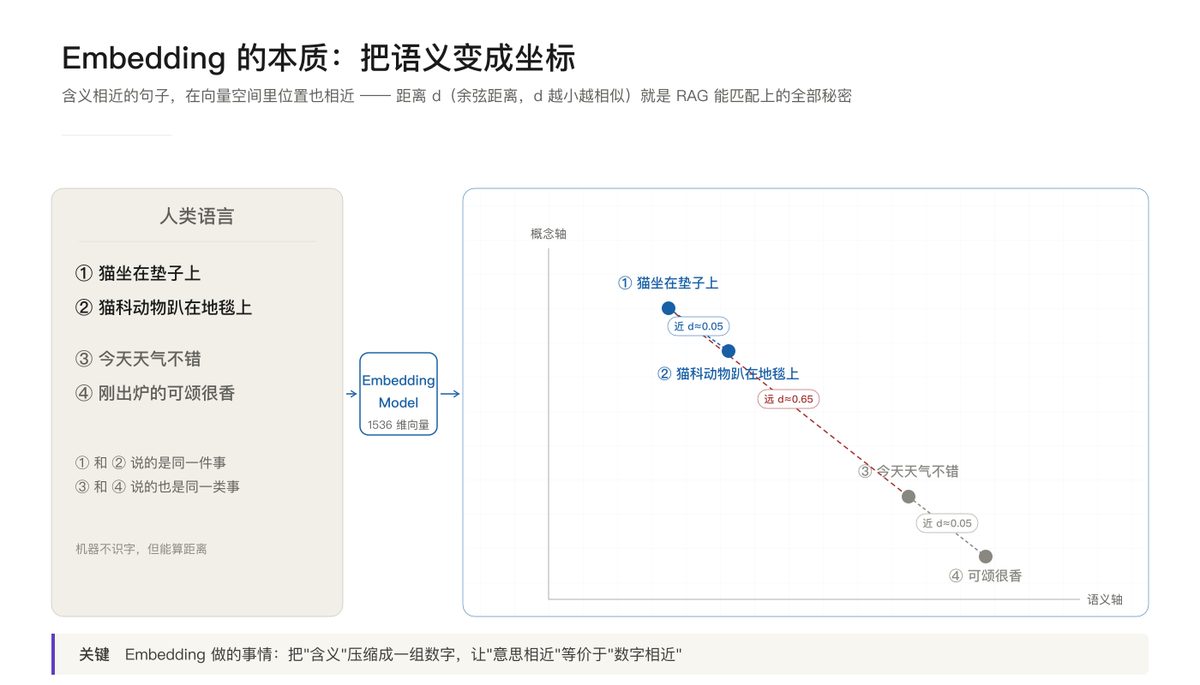
看上面这张图。左边是人类语言,右边是机器能算的"数字空间"。
- "猫坐在垫子上"和"猫科动物趴在地毯上"——人是"看"出来的同一件事
- "今天天气不错"和"刚出炉的可颂很香"——人也"看"出来它们是同一类闲话
Embedding 模型做的事情,就是把人类这种"含义相近"的判断,转换成机器能算的"数字距离"。左边的句子经过模型映射到右边的坐标系里,意思相近的句子的点会挨得近,不相关的点会离得远。
这就是 RAG 能匹配上的全部秘密。
至于模型内部是怎么把字变成数字的——靠的是几亿到几千亿参数的神经网络。这个不需要你懂。你只要知道:调用 embeddingModel.embed("猫坐在垫子上") 就能拿到一串 float[]。
二、相似度怎么算:余弦 vs 欧氏
拿到两组向量,下一步就是"找最近"。问题来了:什么叫"近"?
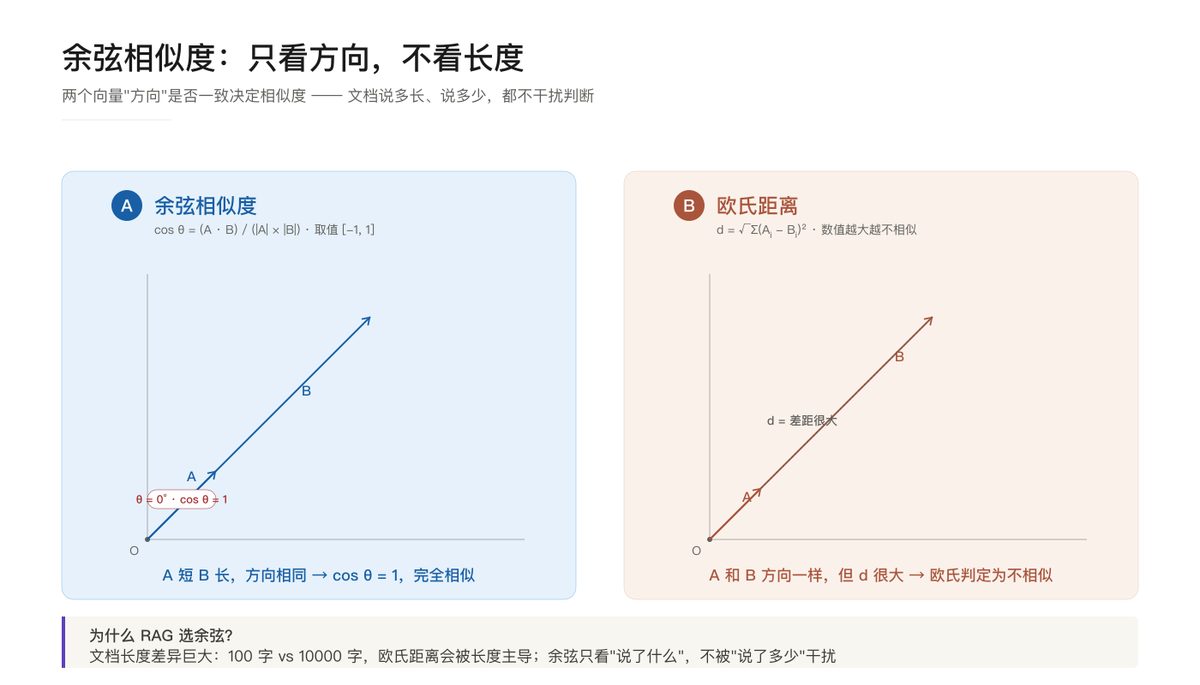
两种主流定义:
| 度量 | 含义 | RAG 选哪个 |
|---|---|---|
| 余弦相似度 | 看两个向量的「方向」是否一致(公式:cosθ) | ✅ 选这个 |
| 欧氏距离 | 看两个向量的「直线距离」有多远 | ❌ 不选 |
为什么 RAG 选余弦不选欧氏?
看右边那张图——A 短 B 长,但方向完全一样。欧氏距离会判"A 和 B 差很远"(d 大),但实际上它们的含义是一样的(都是"猫在某个东西上")。
文档检索场景里,文档长度差异巨大:100 字 vs 10000 字,欧氏距离会被"长度"主导,而不是"含义"主导;余弦只看"说了什么",不被"说了多少"干扰。
实操上,Spring AI 的 SearchRequest 默认就用了余弦相似度(similarityThreshold 取值 0-1),不用你操心。但你得懂这个原理——第五篇讲向量库调参时,看到 cosine_distance / l2_distance 你不会一脸懵。
三、768 / 1024 / 1536 维到底意味着什么
每个 Embedding 模型输出的向量都有"维度"。这玩意儿不是说"维度越高越好"——维度每翻一倍,存储、计算、token 费用都按线性甚至平方涨。
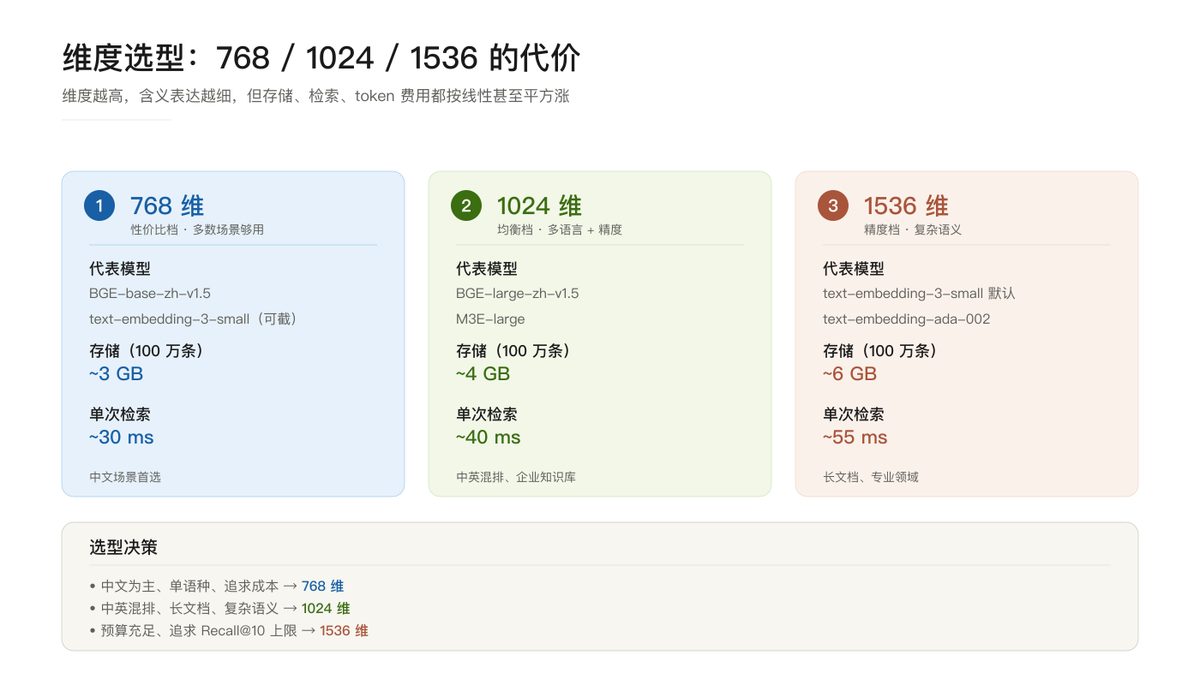
| 档位 | 代表模型 | 存储 / 检索 | 适合场景 |
|---|---|---|---|
| 768 维 | BGE-base-zh、text-emb-3-small 截断 | ~3 GB / ~30 ms | 中文为主、追求成本 |
| 1024 维 | BGE-large-zh、M3E-large | ~4 GB / ~40 ms | 中英混排、企业知识库 |
| 1536 维 | text-emb-3-small、ada-002 | ~6 GB / ~55 ms | 长文档、专业领域 |
经验法则: - 起步选 768(BGE-base-zh)。中文场景它足够好,省存储省 token - 中文 + 英文 + 长文档 + 复杂语义 → 1024 - 预算充足 + 追求 Recall@10 上限 → 1536 - 维度的"边际收益"递减:768→1024 提升 5-8%,1024→1536 只提升 2-3%,但存储费用涨 50%
重要约束:维度和模型强绑定。用 BGE-base 存了 768 维向量,后面想换 OpenAI 的 1536 维模型?整库得重新 Embedding 一遍。所以选模型就是选维度。
四、动手:Spring AI EmbeddingModel 第一个调用
第 1 篇我们讲了全景,第 2 篇我们搭了环境。这篇终于要"看到"向量本身了。
application.properties(接第 2 篇的 OpenAI 配置):
# Embedding 单独配模型:text-embedding-3-small 默认 1536 维
spring.ai.openai.embedding.api-key=${OPENAI_API_KEY}
spring.ai.openai.embedding.base-url=${OPENAI_BASE_URL:https://api.openai.com/v1}
spring.ai.openai.embedding.model=text-embedding-3-small
接 DeepSeek 也行(用同一个 starter),但 DeepSeek 暂时不提供 Embedding API,得单独配个开源模型或者用阿里 DashScope。本篇先用 OpenAI。
Java 代码:
@RestController
class EmbeddingController {
    private final EmbeddingModel embeddingModel;

    EmbeddingController(EmbeddingModel embeddingModel) {
        this.embeddingModel = embeddingModel;
    }

    @GetMapping("/embed")
    Map<String, Object> embed(String text) {
        // 一行调用,返回 float[]
        float[] vector = embeddingModel.embed(text);

        return Map.of(
            "text", text,
            "dimensions", vector.length,
            "first10", Arrays.copyOf(vector, 10),   // 只看前 10 个
            "all_zeros", false                       // 不会全 0
        );
    }
}
启动 → 访问 http://localhost:8080/embed?text=猫坐在垫子上 →
{
  "text": "猫坐在垫子上",
  "dimensions": 1536,
  "first10": [0.0234, -0.0156, 0.0891, -0.0423, 0.0157, -0.0089, 0.0634, -0.0298, 0.0412, -0.0178],
  "all_zeros": false
}
1536 个 float,每个在 -0.1 到 0.1 之间,看起来像噪声。但把"猫坐在垫子上"和"猫科动物趴在地毯上"两句话都 embed 一下,算一下余弦相似度:
@GetMapping("/similarity")
Map<String, Object> similarity(String t1, String t2) {
    float[] v1 = embeddingModel.embed(t1);
    float[] v2 = embeddingModel.embed(t2);

    // 余弦相似度
    double dot = 0, n1 = 0, n2 = 0;
    for (int i = 0; i < v1.length; i++) {
        dot += v1[i] * v2[i];
        n1 += v1[i] * v1[i];
        n2 += v2[i] * v2[i];
    }
    double cos = dot / (Math.sqrt(n1) * Math.sqrt(n2));

    return Map.of("cosine", cos);
}
跑一下:
GET /similarity?t1=猫坐在垫子上&t2=猫科动物趴在地毯上
→ cosine ≈ 0.92  (高度相似)

GET /similarity?t1=猫坐在垫子上&t2=刚出炉的可颂很香
→ cosine ≈ 0.31  (明显不相似)
0.92 vs 0.31——这就是 Embedding 在干的事。把"含义"压缩成数字,让机器能"算"含义。
坑 1:用 DeepSeek 接 Embedding 暂时走不通。国内目前只有阿里 DashScope、智谱 GLM、BGE 自托管 几条路。下篇会专门讲。
坑 2:
dimensions()方法在某些 1.x 老代码里被叫getDimensions()。2.0 统一改成dimensions()(无 get 前缀),新代码按 Bean 规范走。
五、维度差异:换模型必须重算整库
最后一颗钉子——这点不讲清楚,第五篇讲向量库选型时你会翻车。
一个向量库里所有向量的维度必须一致。这是向量数据库的硬性约束(HNSW 索引结构决定)。
意味着什么?
假设你现在用 BGE-base(768 维)存了 100 万条文档。后来想升级到 OpenAI text-embedding-3-large(3072 维):
- 库里的 100 万条向量全部作废
- 必须把 100 万条原文重新喂给新模型
- 重新算 100 万次 embedding(按 OpenAI 价 $0.13/百万 token,你 100 万条文档大概 1 亿 token,要 13 美元)
- 重新写回向量库
所以选 Embedding 模型不是小事——选定了就别轻易换。先用 768 维跑起来,业务跑通了再考虑升维度。
写在最后
这一篇是 RAG 的"灵魂篇"——讲清楚了一句话怎么变成一串数字、相似度怎么算、维度选型的代价。
下一篇《垃圾进,垃圾出》,讲 ETL 管道与切分策略。Embedding 之前,文档得先切好块——切错了一切白搭:表格被拦腰截断、代码块被切断、上下文丢失,每一种都是真实生产事故。
点个"在看"——RAG 这条路很长,咱们一篇一篇扎实推进。
作者:老魏 · 一个把公众号和代码当副业的散户投资者 系列:Java RAG 从零到上线(Spring AI 2.0.1) 下期:垃圾进,垃圾出:ETL 管道与切分策略